GB10 128 GB:哪些 LLM 真正能够运行 (mesures)
在一台 GIGABYTE AI TOP ATOM(NVIDIA GB10,128 GB)上,测得的 13 个模型从 4B 到 235B,在 32 768 个上下文 token 和至少 20 GB 余量下都能运行。大型 MoE 模型每个 token 只激活部分参数,因此比同等规模的稠密模型快得多:gpt-oss 120B 每秒写入 58 个 token。一款 70B 稠密模型每秒写入 4,8 个 token:决定速度的是内存带宽,而不是容量。
一百二十八 GB 的统一内存:这是 GB10 机器相较于显卡的优势。但实际能加载多少内容,有多大余量,速度又如何?我们在 GIGABYTE 免费提供的 AI TOP ATOM 上测量了 13 个模型,范围从 4B 到 235B,并在首次测量前固定了测试方案。以下是能够运行的内容、日常使用体验,以及适合购买它的人群。
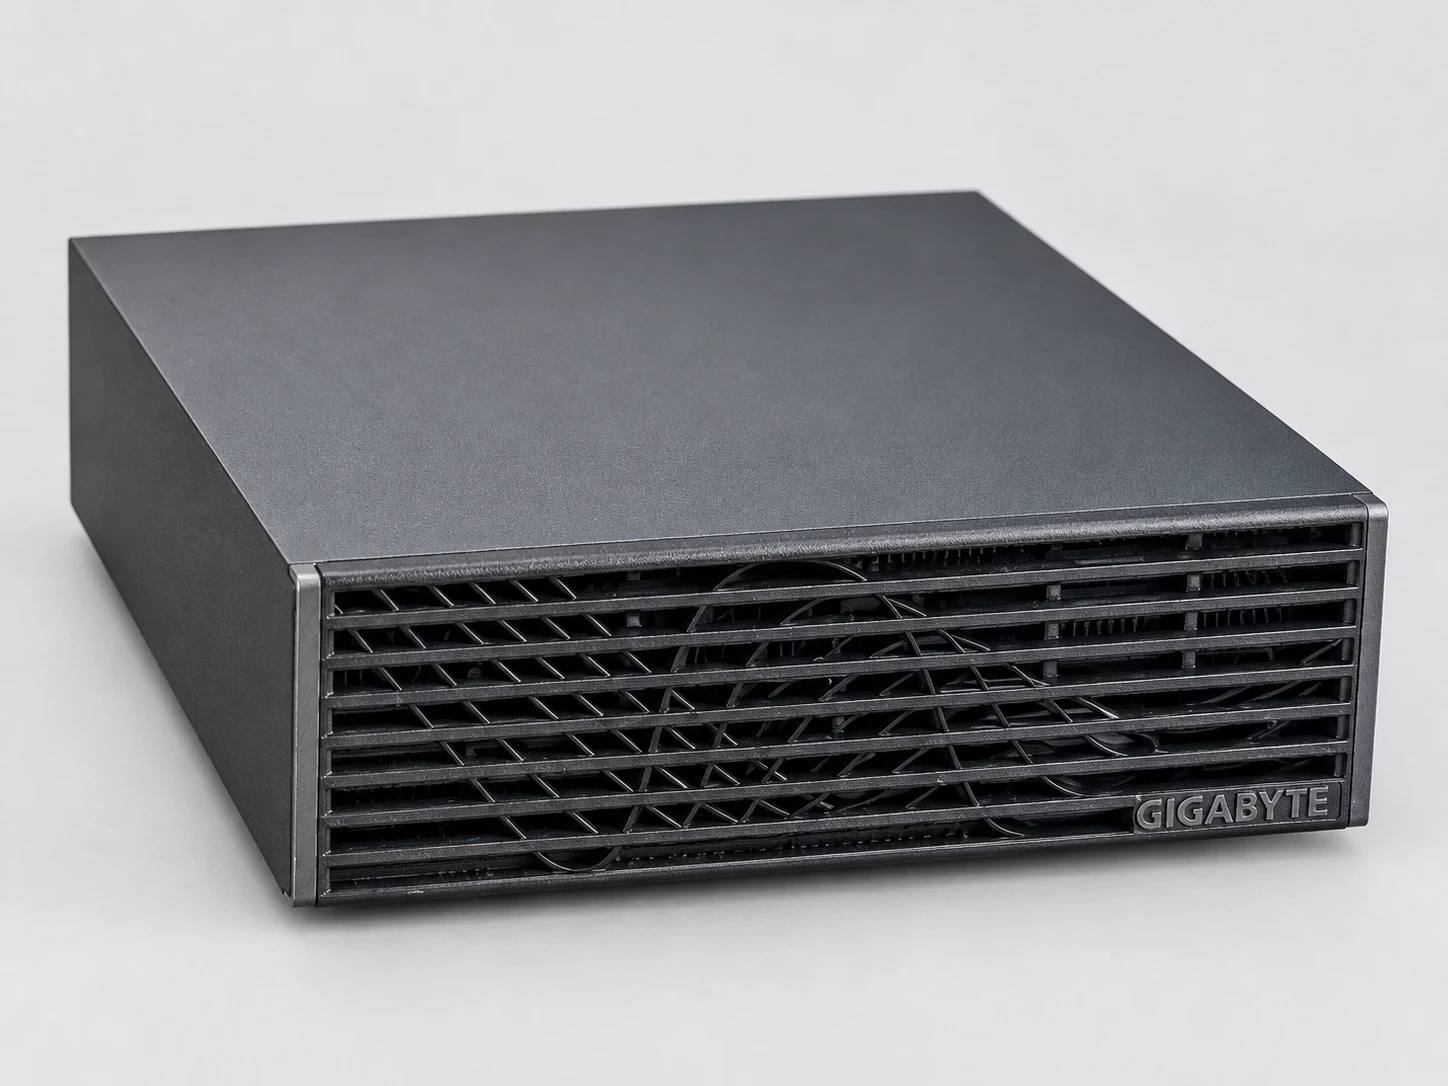
#测试机器
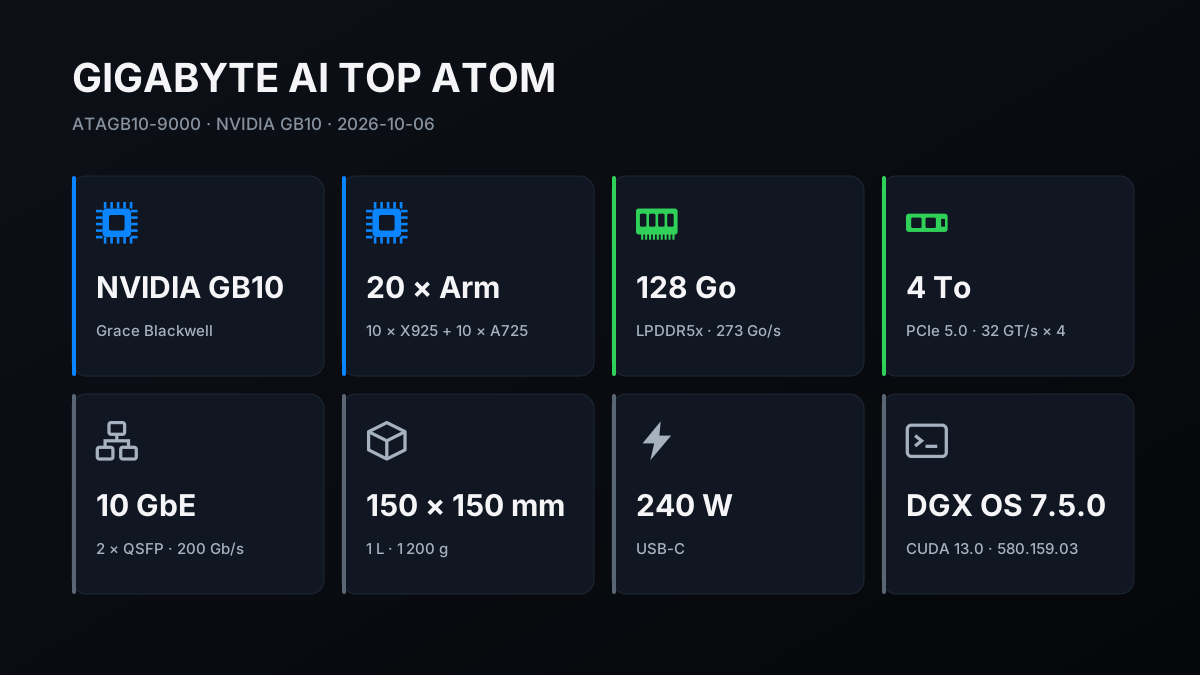
这台机器是 GIGABYTE AI TOP ATOM,型号为 ATAGB10-9000:搭载 NVIDIA GB10 芯片(20 个 Arm 核心和一个共享 128 GB 内存的 Blackwell GPU,标称带宽为 273 GB/s),配备 4 TB PCIe 5.0 SSD。它运行 DGX OS 7.5.0,这是基于 Ubuntu 的 NVIDIA 系统(驱动 580.159.03,CUDA 13.0)。
本次使用了三款软件。llama.cpp 是一种广泛使用的开源本地模型运行引擎,我们在现场为 GB10 芯片编译它,并据此生成主表。Ollama 0.34.1 用于与 MacBook Pro M5 Max 进行对比,后者使用相同版本测量。vLLM 26.09 是一款为同时响应多位用户而设计的服务器,运行在 NVIDIA 提供的容器中。
#我们如何进行测量
llama.cpp 的速度来自五次重复测试,标准差(重复测试之间的离散程度)不超过 3%。加载时间、读取 30 000 个 token 的文档以及内存余量均为单次测量;多用户测试重复三次。在首次测量前,先进行了三分钟测试,以确认 GPU 能够维持其计算功耗。
13 个模型的文件都具有 SHA-256 指纹(文件的数字签名),与托管这些模型的网站 Hugging Face 发布的指纹一致。协议于 10 月 5 日撰写,并在 6 日 13:30 定稿,早于第一次测量。
同日约 16:50 发布的补充说明将冷启动复测提前到当晚,并增加了本文采用的测试:Ollama 官方脚本、推测解码、持续负载,以及使用 NVFP4 的 Llama 3.3 70B。方法、文件指纹和表格数据均已发布在我们的方法页面上。
主要数据在当天晚上经过 20 分钟休息并清空缓存后重新测量:误差最多为 2,6%,低于协议规定的 3% 阈值。
#与 DGX Spark 的速度相同,误差仅为几个百分点
据我们所知,128 GB 的 GB10 机器使用相同的 NVIDIA 芯片和相同的内存;它们的构造、散热和存储可能有所不同。为了给 ATOM 提供参照,我们使用相同的软件版本和相同的设置,重新测试了已发布的 NVIDIA DGX Spark 的两项基准数据。
使用 llama.cpp(build 7941,即该项目发布的表格所用版本;我们的主表使用更新的 build 11430)时,在六个共同模型上,读取结果的差异不超过 2,3%;写入速度中位数低 2,8%,最多低 4,3%。使用 Ollama 的官方脚本(版本 0.12.6,即其发布测量结果所用版本)时,我们的三项测量在读取和写入方面的差异都不超过 2%:gpt-oss 20B、gpt-oss 120B 和 Llama 3.1 70B。
因此,本指南中的速度对于其他配备 128 GB 的 GB10 机器来说,误差在几个百分点以内应当同样适用;我们只测量了 ATOM。它的构造和负载表现(温度、1 小时和 2 小时的稳定性)将在本系列下一篇指南中详细介绍,功耗则见专门的指南。
#13 个模型,从 4B 到 235B:占用空间与速度
该表总结了本轮测试。“占用内存”指模型加载后、预留 32,768 个上下文 token 时可用内存的减少量。“加载”指冷启动加载时间,即磁盘缓存已清空。速度来自测量工具 llama-bench(llama.cpp,2026 年 10 月 5 日的 build 11430),分别在空上下文和已有 32,768 个 token 的情况下测得;长文档的实际耗时见下文。
| 模型 | 类型 | 已占用内存 | Chargement | 写入(空白 → 32k) | 读取(空 → 32k) | 用途 |
|---|---|---|---|---|---|---|
| Gemma 3 4B(Q4_0) | dense | 4.6 GB | 3 s | 80,8 → 63,6 | 6 239 → 5 409 | 非常流畅 |
| Qwen2.5-Coder 7B(Q8_0) | dense | 10.2 GB | 3 s | 30,0 → 23,3 | 3 746 → 2 138 | fluide |
| gpt-oss 20B (MXFP4) | MoE,3,6 Md 个激活参数 | 13.0 GB | 4 s | 81,4 → 62,5 | 4 950 → 3 316 | 非常流畅 |
| Qwen3.8 27B (Q4_K_XL) | dense | 19,1 GB | 5 s | 11,8 → 10,6 | 865 → 717 | correct |
| Qwen3.6 35B-A3B(Q4_K_XL) | MoE,3 十亿个活跃参数 | 22,4 GB | 5 s | 66,0 → 55,6 | 2 987 → 2 429 | 非常流畅 |
| GLM-4.7-Flash(Q8_0) | MoE,3 十亿个活跃参数 | 32,6 GB | 6 s | 51,4 → 35,5 | 2 392 → 608 | 非常流畅 |
| Qwen3-Coder 30B-A3B(Q8_0) | MoE,激活 3,3 Md 参数 | 34.3 GB | 6 s | 62,6 → 33,2 | 3 377 → 1 603 | 非常流畅 |
| Llama 3.3 70B (Q4_K_M) | dense | 51,1 GB | 8 s | 4,8 → 3,9 | 405 → 269 | 适合批处理 |
| gpt-oss 120B(MXFP4) | MoE,5,1 十亿个活跃参数 | 61,7 GB | 10 s | 58,0 → 42,2 | 2 609 → 1 832 | 非常流畅 |
| Qwen3.5 122B-A10B (Q4_K_XL) | MoE,激活参数 10 Md | 74.5 GB | 12 s | 23,1 → 21,4 | 1 126 → 945 | fluide |
| Nemotron-3 Super 120B-A12B(Q4_K_XL) | MoE,12 Md 活跃参数 | 80,4 GB | 12 s | 16,9 → 16,5 | 851 → 809 | correct |
| Qwen3.8-Flash-Next 125B(IQ4_XS) | MoE,约 6 十亿个活跃参数 | 89.5 GB | 21 s | 27,3 → 25,2 | 1 073 → 917 | fluide |
| Qwen3-235B-A22B (Q2_K_XL) | MoE,活跃参数 22 Md | 90,5 GB | 12 s | 17,7 → 11,8 | 588 → 331 | 正确;高强度压缩(Q2) |
阅读表格时请注意:稠密模型在每个 token 上都会使用全部参数,而 MoE(“mixture of experts”,专家混合)模型只使用其中一部分,参数量以十亿(Md)为单位表示。括号中的缩写表示权重压缩方式。在我们的文件中,Q8 每个参数占 8,5 bit,Q4 和 MXFP4 格式占 4,3 到 5,6 bit,而 Q2_K_XL 占 3 bit,是表中压缩程度最高的格式。
“用途”列将我们的标准应用于空上下文下的写入速度:每秒超过 40 个 token 时非常流畅,20 到 40 时流畅,10 到 20 时尚可。低于此速度时,我们仅将模型用于批处理。
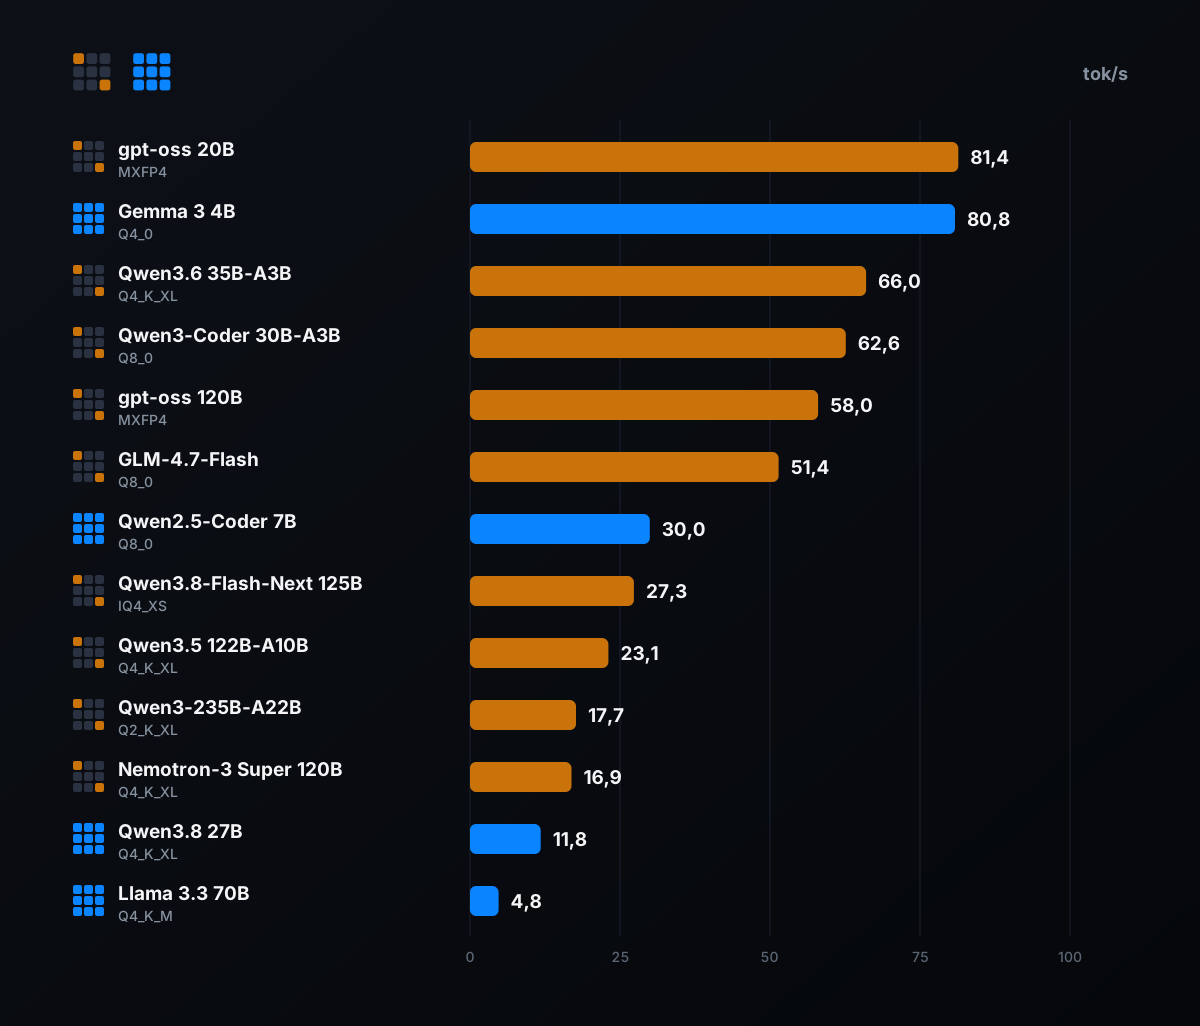
第一点:表中的任何内容都不会让这台机器陷入困境;即使是 Qwen3-235B,在 30 000 个 token 的上下文下也仍有 21 GB 可用空间。第二点对选择更有帮助:空间几乎从来不是限制;决定速度的是模型选择,范围从每秒 4,8 到 81,4 个 token。
#决定速度的因素:活跃参数,而不是模型规模
为了写入每个 token,芯片必须从内存中重新读取服务于该 token 的权重。带宽为 273 GB/s 时,最大速度可以简单计算为:273 除以每个 token 读取的权重总量。稠密模型每次都会读取全部权重;MoE 模型只读取其中一部分,即为该 token 选择的“专家”。
这解释了表格中的悖论。gpt-oss 120B 文件大小为 59 GB,但模型每个 token 只激活 51 亿个参数,因此写入速度达到每秒 58.0 tokens。Qwen3.8 27B 的文件小三倍多(16 GB),但它是稠密模型:每个 token 都会激活其 270 亿个参数,写入速度为每秒 11.8 tokens。大模型的速度接近小模型的五倍。
| 模型 | 当前激活参数 | 理论上限 | 测得 | 占上限的比例 |
|---|---|---|---|---|
| Qwen2.5-Coder 7B(稠密) | 7,6 十亿 | 33,7 | 30,0 | 89 % |
| Llama 3.3 70B(稠密模型) | 70.6 Md | 6,4 | 4,8 | 74 % |
| Qwen3.8 27B(稠密) | 27.3 Md | 15,6 | 11,8 | 76 % |
| Qwen3-Coder 30B-A3B (MoE) | 3.3 Md | 77,8 | 62,6 | 81 % |
| gpt-oss 120B(MoE) | 5,1 Md | 98,7 | 58,0 | 59 % |
| Qwen3.6 35B-A3B(MoE) | 3 十亿 | 141,1 | 66,0 | 47 % |
表格列出了六个模型,即那些活跃参数数量已由 llama.cpp 发布或测得的模型。稠密模型达到这一上限的 74% 至 89%:GB10 几乎用尽了其全部内存。
在全部十三个模型中,除 Qwen3.8-Flash-Next 外的八个 MoE 达到了 47% 至 81%;其中六个处于 52% 至 62% 之间。专家选择和附加计算可能会为每个 token 增加固定耗时。Qwen3.8-Flash-Next 不计入此计算:除 1250 亿参数外,它还包含 510 亿个查找表参数,因此这种估算并不适用。
不过,在规模相近的情况下,MoE 仍然快得多。因此我们的主要建议是:在 GB10 机器上运行大型模型时,优先选择 MoE。像 Gemma 3 4B 这样的小型稠密模型写入速度也很快(每秒 80.8 个 token),但它小得多,适用于其他用途。
#参数量超过 1000 亿的模型
这正是 128 GB 存在的意义。NVIDIA 宣称该平台可运行最高 2000 亿参数的模型;我们的测量结果证实了这一承诺,甚至经过 3 bit 压缩的 235B 模型也能容纳。五个超过 1000 亿参数的模型都能在 ATOM 上运行,在 30 000 tokens 上下文下仍各自至少保留 20 GB 余量。
- gpt-oss 120B,速度与空间的最佳折中
- 每秒 58,0 个 tokens,占用 61,7 GB,并在 10 秒内完成加载。OpenAI 直接以 MXFP4 格式发布它:无需额外压缩即可容纳。
- Qwen3.8-Flash-Next 125B,巨型 Qwen 中速度最快的模型
- 每秒 27.3 个 token,约有 60 亿个活跃参数,在 IQ4_XS 中占用 89.5 GB。其压缩程度较低的 Q4_K_XL 版本也能装下,但余量很小(见下文)。
- Qwen3.5 122B-A10B
- 每秒 23.1 个 token,74.5 GB;其一百亿个活跃参数使其性能落后于 gpt-oss。
- Nemotron-3 Super 120B-A12B(NVIDIA)
- 每秒 16.9 个 token,80.4 GB。它拥有一百二十亿个活跃参数,写入速度低于 gpt-oss;但在上下文变长时,它的写入性能保持得最好:从 16.5 到 32,768 个 token,约低 3%。
- 另说 Qwen3-235B-A22B
- 它可以使用 Q2_K_XL 运行,这是表格中压缩程度最高的方案(平均每个参数 3 比特):每秒 17.7 个 token,90.5 GB。如此高强度的压缩通常会降低回答质量;我们没有对此进行测量。
#内存的边界:约为 100 到 105 GB 的权重
系统显示有 121.7 GB 内存:128 GB 中有一部分在启动时就已预留。机器启动后,在没有其他内容占用内存的情况下,根据不同时间点,仍有 108 到 113 GB 可用。为了找出上限,我们加载了最大模型的两个更大版本,使用相同的 32 768 个令牌上下文,并设置了一个保护机制:可用内存低于 3 GB 时停止加载。
| 模型 | 文件 | 已占用内存 | 剩余显存余量 | 写入(读取 4 000 → 30 000 个 tokens 后) | Place |
|---|---|---|---|---|---|
| Qwen3.8-Flash-Next 125B(Q4_K_XL) | 103,7 GB | 107.0 GB | 6.0 GB | 24,9 → 21,9 tok/s | 勉强能容纳 |
| Qwen3-235B-A22B(Q3_K_XL,3,5 bit) | 97,0 GB | 104.7 GB | 8,2 GB | 13,9 → 10,4 tok/s | 勉强能容纳 |
没有模型加载失败,但这两个模型留下的余量很小:几乎没有空间再放第二个模型、更长的上下文,或旁边运行一个占用资源较多的应用。因此,实际限制大约在 100 到 105 GB 的权重。比如,Qwen3.8-Flash-Next 的 NVFP4 权重(NVIDIA 的一种压缩格式)就不在此范围内:据 Kubesimplify 博客(2026 年 8 月 27 日)称,约为 135 GB;该博客还明确指出,这种情况下需要两台机器。
这篇文章当时已经展示了该模型在单台机器上以 GGUF(llama.cpp 的格式)运行,但当时只有压缩程度最高的版本。现在,ATOM 可以运行 IQ4_XS 和 Q4_K_XL 版本,并分别有 21 和 6 GB 的余量。
#长上下文的代价
无论是长文档、代码库,还是不断延长的对话:上下文中已经存在的每个 token 都会拖慢后续处理。在内存中保留 32 768 个 token 时,根据模型不同,写入速度会下降 3% 至 47%。我们还实际测量了整块读取一份 30 000 token、约五十页文档所需的时间。
| 模型 | 读取 30 000 个 tokens | 随后写入 |
|---|---|---|
| Gemma 3 4B | 4,7 s | 60.8 tok/s |
| gpt-oss 20B | 8,1 s | 61,6 tok/s |
| Qwen2.5-Coder 7B | 12,7 s | 23,3 tok/s |
| Qwen3.6 35B-A3B | 14,2 s | 54.4 tok/s |
| Qwen3-Coder 30B-A3B | 17,4 s | 33.3 个令牌/秒 |
| gpt-oss 120B | 21,8 s | 42,8 tok/s |
| GLM-4.7-Flash | 32,7 s | 35,6 tok/s |
| Qwen3.8 27B | 39,4 s | 10,6 tok/s |
| Qwen3.8-Flash-Next 125B | 42,9 s | 23.0 tok/s |
| Qwen3.5 122B-A10B | 43,6 s | 21,2 tok/s |
| Nemotron-3 Super 120B-A12B | 55,4 s | 16,2 tok/s |
| Qwen3-235B-A22B | 1 分 33 秒 | 12,1 tok/s |
| Llama 3.3 70B | 1 分 44 秒 | 4,0 tok/s |
对于大多数模型,这些时间比第一张表中“读取”列所暗示的更长。可能的原因是:实际使用的服务器 llama-server 默认按 512 个 token 的批次处理文本,而我们的 llama-bench 配置使用的是 2 048 个 token。
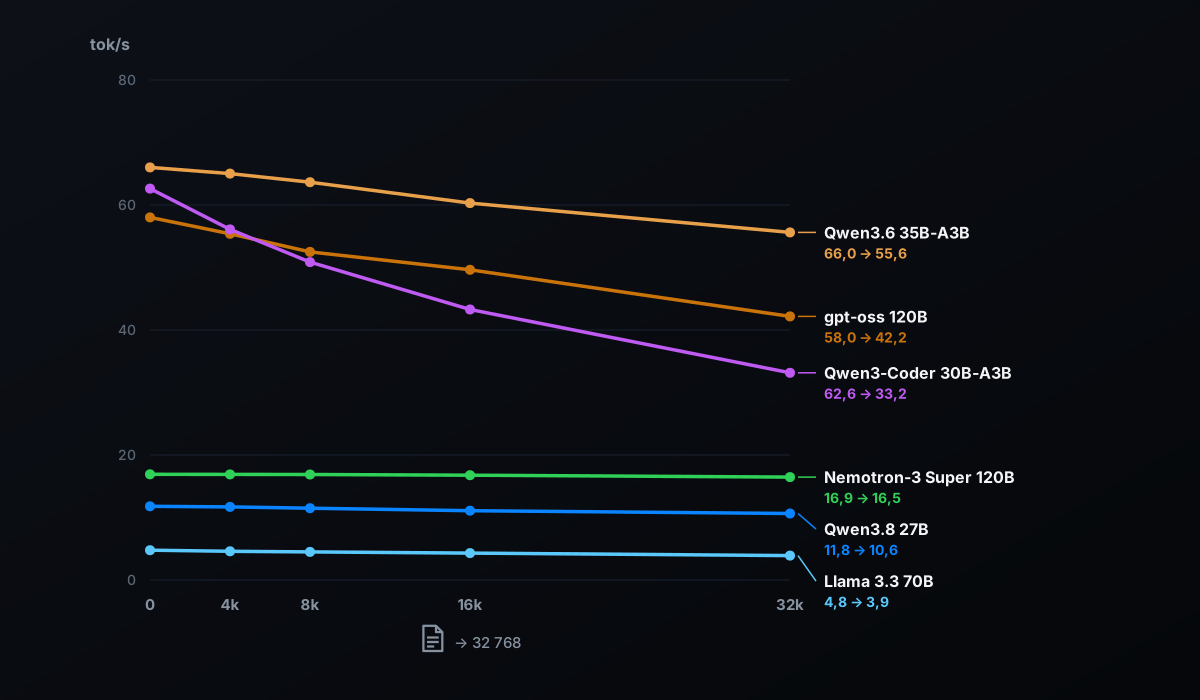
读取是 GB10 的强项:与下文对比的 Mac 相比,它读取 gpt-oss 120B 的速度快 31%。如果您提交一份约五十页的报告,使用 gpt-oss 120B 时会在 22 秒后开始响应,而使用密集型 70B 模型时则要等 1 分 44 秒。对于文档分析和代码代理而言,这一指标影响很大。
#最多同时容纳 16 名用户:这台机器能承受的负载
使用 vLLM,我们模拟了 1、8,然后 16 个并发用户。每个用户发送 1 024 个 token 的请求,并接收 512 个 token 的响应;每个数据点使用不同请求测量三次,我们公布中位数。
| 模型 | 用户 | Total | 每人 | 首词(平均值) | 首个 token(最慢的情况) |
|---|---|---|---|---|---|
| gpt-oss 120B | 1 | 35,6 tok/s | 36,4 tok/s | 0,34 s | 0,35 s |
| gpt-oss 120B | 8 | 113,9 tok/s | 14,5 tok/s | 0,97 s | 1,62 s |
| gpt-oss 120B | 16 | 160,3 tok/s | 10,2 tok/s | 1,07 s | 3,71 s |
| gpt-oss 20B | 1 | 49,1 tok/s | 50,0 tok/s | 0,16 s | 0,16 s |
| gpt-oss 20B | 8 | 205,9 tok/s | 26,5 tok/s | 0,49 s | 0,81 s |
| gpt-oss 20B | 16 | 322,4 tok/s | 20,7 tok/s | 0,52 s | 1,73 s |
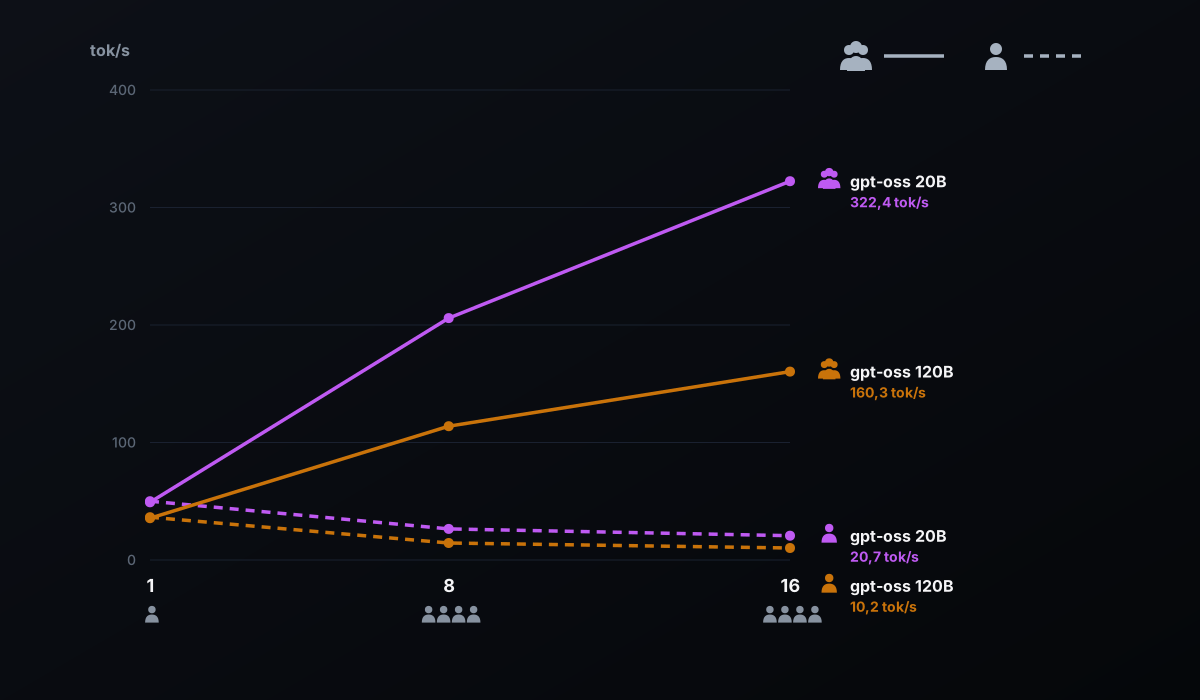
在 1 到 16 个用户之间,总吞吐量使用 gpt-oss 120B 时提高 4,5 倍,使用 gpt-oss 20B 时提高 6,6 倍:当多个请求共享相同权重的读取时,芯片可以充分发挥其计算能力。
即使有 16 个人,每个人仍能看到自己的回答以每秒 10 个 token 的速度生成(使用 gpt-oss 120B),使用 gpt-oss 20B 时则为每秒 21 个 token。使用 1200 亿参数的模型时,平均稍多于一秒即可生成第一个词,而在最慢的情况下则接近 4 秒。
不过,对于单人使用,vLLM 并不是最快的:在不进行特别性能调优的情况下,它在 gpt-oss 120B 上的写入速度为每秒 36,4 个 token,而 llama.cpp 在较长响应上的速度为 54,4。其日志显示,它在 GB10 上为 MXFP4 格式选择了 Marlin 计算内核,这很可能解释了差距。当多人或多个代理共享机器时,vLLM 才显出合理性。
#独自面对机器:Ollama 还是 llama.cpp?
Ollama 是最简单的入门方式,而且无需调整即可在 GB10 上运行。然而在 gpt-oss 上,它并不是最快的。在较长的回答中,0.34.1 版本在 gpt-oss 120B 上的写入速度为每秒 42.3 个 token,而相同 MXFP4 格式下 llama.cpp 为 54.4 个 token,也就是低 22%。在 gpt-oss 20B 上则为 58.8 对 78.8,低 25%。
对于 Qwen 系列模型,情况正好相反。在 Qwen3.8 27B 上,Ollama 根据片段不同,每秒写入 22,9 到 30,5 个 token,而默认配置的 llama.cpp 为 11,8;在 Qwen3.6 35B-A3B 上则为 90,5 到 94,9,而后者为 66,0。可能的原因是:Ollama 默认启用了推测解码,会提前提出多个 token,再由模型一次性验证(这些模型的配置中出现了 draft_num_predict 设置)。
我们的测试也印证了这一点。在 llama-server 上(六篇各含 400 个 token 的文本,包括散文和代码),llama.cpp 的推测解码(MTP,即一次预测多个 token)将 Qwen3.8 27B 在散文上的速度从每秒 11.7 个 token 提升到 21.5 个,在代码上的速度从 11.6 提升到 27.2。
实际使用中:使用 Ollama 进行启动,并用于 Qwen 模型,它会自动加速这些模型;使用 llama.cpp 来发挥 gpt-oss 的最大性能,或启用 Qwen3.8 的推测解码。最佳选择更多取决于设置,而不是机器本身。
#对比 MacBook Pro M5 Max 128 GB
一位读者于 9 月 16 日使用 Ollama 0.34.1,在单次遍历每个模型的情况下测量了其配备 40 核 GPU 的 MacBook Pro M5 Max 128 GB;他的测量结果已发布在我们的专门指南中。我们在 ATOM 上以两次遍历重做了相同的系列测试:使用 Ollama 的相同版本、相同模型和相同提示词。
| 测量 | ATOM,第一个测试结果 | ATOM,第二次通过 | MacBook Pro M5 Max | 差异 |
|---|---|---|---|---|
| 写作,gemma4:12b | 45,9 | 54,1 | 58,1 | Mac 快 7% 到 27% |
| 写入,qwen3.8:27b | 30,5 | 22,9 | 36,6 | Mac +20 至 +59 % |
| 写入,gpt-oss:20b | 58,1 | 58,8 | 113,4 | Mac +93 至 +95 % |
| 写入,gpt-oss:120b | 42,2 | 42,3 | 79,1 | Mac +87 % |
| 读取 gpt-oss:120b | 1 816 | — | 1 388 | ATOM +31 % |
Mac 在四种模型上的写入速度都更快,在两个 gpt-oss 上接近快两倍;两者的测试结果相互吻合:其芯片的带宽为 614 GB/s,是 GB10 的两倍以上。在 gemma4 和 qwen3.8 上,差距会随测试结果而变化;推测解码的收益取决于生成的文本,这可能是原因之一。
ATOM 读取速度更快,可能得益于其 GPU 的计算能力;测试文本相近但并不完全相同(16 850 和 16 689 个 token)。使用 llama.cpp 时,写入速度差距缩小:gpt-oss 120B 为每秒 54.4 个 token,而 Mac 在 Ollama 下为 79.1 个。
#谁适合选择 ATOM
以下内容来自我们在 ATOM 上的测量。
- 如果你想在本地运行大型模型,ATOM 是正确的选择
- 五个超过 1000 亿参数的模型都能留有余量地运行。据我们所知,没有任何面向大众的显卡接近这 128 GB。
- ……如果你处理的是长文档或代码
- 使用 gpt-oss 120B 在 22 秒内读取 30 000 个 token。
- ……如果由多个人或代理共享它
- gpt-oss 120B 上 16 个用户的总吞吐量为每秒 160 个 tokens。
- ……如果您想要NVIDIA生态
- CUDA 13、NVIDIA 容器中的 vLLM,以及针对 GB10 芯片编译的 llama.cpp,在我们的 DGX OS 7.5.0 上运行正常。
- 如果您独自使用,并且首先追求写入速度
- 与 MacBook Pro M5 Max 比较:凭借 614 GB/s 的带宽,它在 gpt-oss 上的写入速度更快;而在 gpt-oss 120B 上,ATOM 读取长文档的速度快 31%。也请比较价格。
- 如果您的模型保持在 35 GB 以下
- 预计 2026 年 10 月 23 日发布的 64 GB 版本 ATOM 应该足够(计算结果来自我们的测量,但未在此版本上实测)。
#64 还是 128 GB?
2026 年 10 月 2 日,NVIDIA 宣布推出配备 64 GB 内存的 DGX Spark,可运行最多 1,000 亿参数的模型,并将于 10 月 23 日由 Acer、ASUS、Dell、GIGABYTE、HP 和 MSI 发售,起价 4,999 美元。GIGABYTE 于 10 月 5 日确认推出采用相同设计的 64 GB AI TOP ATOM。我们没有对其进行测量。
我们的记录可以用于计算。最多到 Qwen3-Coder 30B-A3B 的模型,在使用 32 768 个令牌上下文时占用不到 35 GB,应该可以运行;Llama 3.3 70B(51 GB)将处于临界状态。gpt-oss 120B(62 GB)以及更大的模型将无法容纳。在带宽相同的情况下——这一点仍需验证——速度应该相近。
对于在单台机器上运行的超过 1000 亿参数的模型,应选择 128 GB 版本。根据 NVIDIA,两台通过连接组成一体的 64 GB 机器也可以共享内存;我们没有对此进行测试。
#记录的价格
2026 年 10 月 8 日,PCIe 4.0 的 4 TB 版本(ATAGB10-9001,使用相同的 GB10 芯片和相同的 128 GB)在 AORUS 官方商店的含税标价为 6 346.27 €,但已售罄;Amazon.fr 上有库存,由 Amazon UK 销售(一个)。测试版本为 PCIe 5.0 的 4 TB 版本(ATAGB10-9000),在 LDLC 和 Materiel.net 的价格均为 7 999.95 €,目前缺货。
这些设备的价格和库存变化很快:购买前请核实。
#我们的结论
ATOM 非常适合在家中运行 1200 亿参数的模型、与团队共享,或快速阅读长文档。它为我们提供了该平台的基准性能;根据我们的记录,即使在 16 个用户连续负载一小时期间,也没有出现热限制。如果预算有限,其 PCIe 4.0 版本仍保留相同的芯片和内存。
#我们没有测量的内容
- 回答质量
- 本指南衡量的是哪些内容能够运行以及运行速度,而不是评价每个模型的优劣。
- 温度、噪声和功耗
- 本系列的下一篇指南将详细介绍长时间负载下的温度;功耗另有专门指南,读数取自芯片(仅 GPU)。至于噪音,我们引用 Hardware & Co 的测量结果。
- 超过 32,768 个 token 的上下文
- 多个模型支持长得多的上下文;本指南将上限设为 32 768 个 token,而该系列的 70B 教程最高支持 131 072 个 token,适用于 Llama 3.3 70B 和 gpt-oss 120B。
- 其他 GB10 机器和 64 GB 版本
- 我们的数据与 NVIDIA 发布的 DGX Spark 数据一致,但我们只测量了 ATOM 128 GB。
更新与修正:如果 DGX OS、llama.cpp 或 Ollama 的新版本改变这些结果,本页面将进行修订;每次修正都会标注日期。
#FAQ
在一台 128 GB 的 GB10 机器上,能运行的最大模型是多少?+
70B 模型能否在 GB10 上日常使用?+
本指南中的速度是否适用于 NVIDIA 的 DGX Spark 或其他品牌?+
应该选择 64 GB 还是 128 GB 版本?+
Ollama 是 GB10 机器上的最佳选择吗?+
有反馈、发现了错误,或想补充说明?请告诉我们,让这份指南对每个人都更有帮助。