GIGABYTE AI TOP ATOM:详细测量 128 GB GB10
GIGABYTE 的 AI 迷你 PC:NVIDIA GB10 芯片和 128 GB 统一内存,装在一升机箱中。我们来看看运行 LLM 真正重要的因素 在本地 :内存、带宽、速度、价格——以及它适合或不适合哪些人购买。
更新于 09/10/2026
购买渠道
按钮所标注的配置就是购买时提供的配置。使用迷你 PC 时,请为系统预留内存,并检查推理引擎;macOS/MLX 与 CUDA 不能互换。
联盟链接 — QuelLLM 可能会从购买中收取佣金,这不会给您增加额外费用,且不影响这些推荐(推荐是独立制定的)。作为亚马逊合作伙伴,QuelLLM 将从符合条件的购买中获利。
技术规格
- 内存128 GB 统一内存(LPDDR5x),系统可见 121.7 GB
- 带宽273 GB/s
- 计算Blackwell GPU 和 20 个 Arm 核心;根据 NVIDIA,FP4 下借助稀疏性最高可达 1 PFLOP(厂商声明,未经我们测量)
- 功耗240 W USB-C 适配器;根据我们的记录,GPU 空闲时为 10,4 W,负载时平均为 39 至 53 W(仅 GPU,不使用功率计)
- 参考价格6 346,27 €(ATAGB10-9001,4 TB PCIe 4.0,AORUS 官方商店,已售罄;Amazon.fr 有库存)· 7 999,95 €(ATAGB10-9000,4 TB PCIe 5.0,LDLC 和 Materiel.net,缺货)——截至 08/10/2026 的记录
- 可运行的最大模型3 bit 的 Qwen3-235B-A22B(占用 90,5 GB,余量 21 GB)· Llama 3.3 70B 约每秒 5 个 token,使用较小的草稿模型时速度提高 2,6 至 4 倍 · gpt-oss 120B 每秒 58 个 token;我们的 13 个模型,从 4B 到 235B,均可在 32 768 个 token 的上下文下运行
适合谁?
优势与局限
✓ 优点
- 128 GB 统一内存:我们的 13 个模型,从 4B 到 235B(3 bit),在 32 768 个 token 的上下文下都能运行
- DGX Spark 的速度:使用 llama.cpp 时最多相差 4.3%,使用 Ollama 时最多相差 2%,与 NVIDIA 相比
- 持续满载时速度稳定:16 个用户运行 1 小时,偏差为 0.0%;8 个用户运行 2 小时,偏差为 −0.6%;未报告限速
- ATAGB10-9000 上的 4 TB PCIe 5.0 SSD:读取速度 13 GB/s
- 完整 CUDA 软件栈:llama.cpp、vLLM、TensorRT-LLM 和 Unsloth 均在我们这里运行成功
- 一升机箱,1,2 kg,简洁的前面板
✗ 局限性
- 价格高于配备 128 GB 内存的 Ryzen AI Max+ 395 迷你 PC
- 70B 稠密模型的写入速度约为每秒 5 个 token,受 GB10 平台带宽(273 GB/s)限制:MoE 模型或较小的草稿模型(×2,6 至 ×4)可以带来适合对话的速度
我们测量的结果
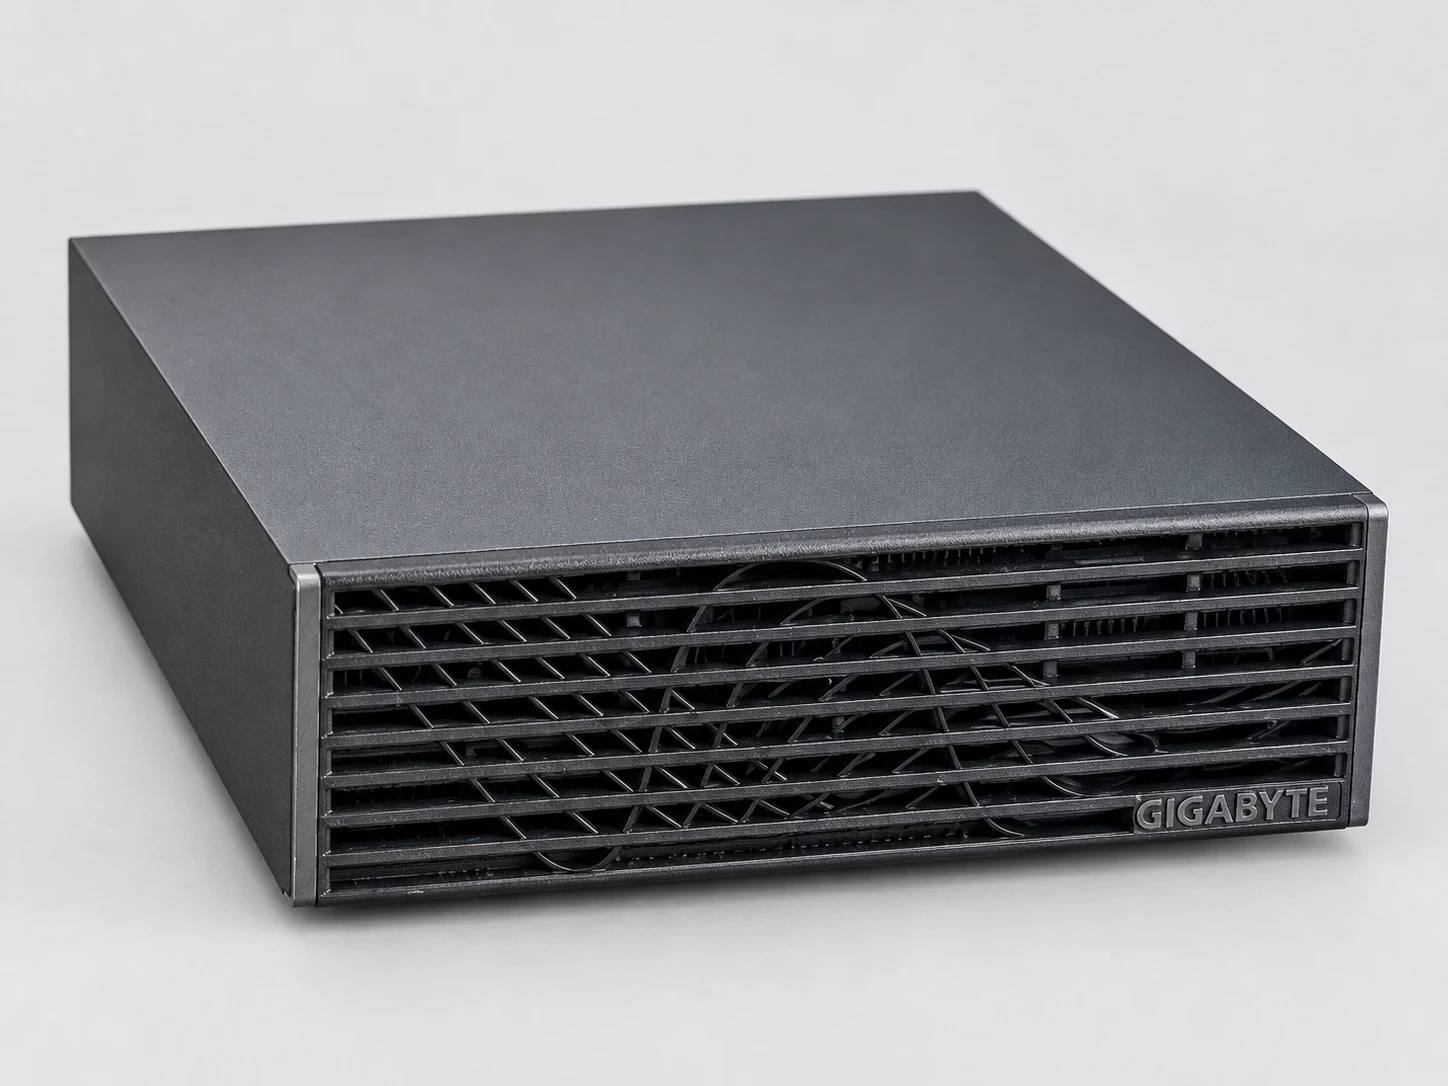
GIGABYTE 免费向我们提供了一台 AI TOP ATOM(ATAGB10-9000:128 GB、4 TB PCIe 5.0 SSD),用于制作一系列指南。测量结果和观点均为我们自己的;GIGABYTE 在内容发布前既未审阅也未批准这些内容。方法(在首次测量前固定的测试协议)、模型文件的指纹,以及我们表格中的数据均发布在我们的网站上 方法页面。我们的数据、信息图和照片均可在许可证下重复使用 CC BY 4.0,并注明 quelllm.fr。
| Guide | 它展示的内容 |
|---|---|
| 哪些 LLM 真正能够运行 | 从 4B 到 235B 的 13 个模型:均可在 32 768 个 token 的上下文下运行;gpt-oss 120B 每秒 58 个 token |
该系列共 7 篇指南,每周发布一篇:每有新指南发布,此页面都会补充更新。
AI TOP ATOM 型号
GIGABYTE 将 ATOM 分为六个型号,从 ATAGB10-9000 到 ATAGB10-9005。前三个型号均为 128 GB:9000 配备 PCIe 5.0 的 4 TB SSD(即我们测量的型号),9001 配备 PCIe 4.0 的 4 TB SSD,9002 配备 PCIe 4.0 的 1 TB SSD。64 GB 版本宣布将于 2026 年 10 月 23 日起推出。请向经销商确认准确型号:部分产品信息对 SSD 的描述有误。
适用人群
- 一支由 5 到 20 人组成的团队 希望在自己的文档上使用私有 AI 助手的人(已测量最多同时 10 名用户)。
- CUDA 开发者 希望在自己的桌面上拥有完整的 NVIDIA 软件栈。
- 本地微调 使用 Unsloth 对 Qwen3-8B 进行 LoRA、对 70B 进行 QLoRA,以及对 gpt-oss 120B 进行处理。
- 大型 MoE 模型 超过 1000 亿个参数,速度也很舒适。
结论
常见问题
GIGABYTE AI TOP ATOM 能否在本地运行 70B LLM?
3 bit 的 Qwen3-235B-A22B(占用 90.5 GB,余量 21 GB)· Llama 3.3 70B 约为每秒 5 个 token,使用小型草稿模型时快 2.6 至 4 倍 · gpt-oss 120B 为每秒 58 个 token;我们的 13 个模型,从 4B 到 235B,都能在 32 768 个 token 的上下文长度下运行。
GIGABYTE AI TOP ATOM 多少钱?
计入 6 346,27 €(ATAGB10-9001,4 TB PCIe 4.0,AORUS 官方商店,已售罄;Amazon.fr 有库存)· 7 999,95 €(ATAGB10-9000,4 TB PCIe 5.0,LDLC 和 Materiel.net,缺货)——截至 08/10/2026 的记录(NVIDIA 宣布 64 GB 版本起价为 4 999 $(美国),将于 23/10/2026 起供货;GIGABYTE 于 05/10/2026 确认推出 AI TOP ATOM 64 GB)。价格变化很快——请通过购买链接核实当日价格。
GIGABYTE AI TOP ATOM 适合谁?
CUDA 开发者、希望拥有私有 AI 助手的团队、本地微调,以及超过 100B 的大型 MoE 模型。