GB10、Ryzen AI Max+ 395 还是 Mac:哪个 最快?
在相同引擎(llama.cpp)下,搭载 NVIDIA GB10 芯片的 AI TOP ATOM 读取提示词的速度是 Ryzen AI Max+ 395 的 2.1 至 2.8 倍,在已公开的参考模型上比 Mac M5 Max 快 23%。在生成方面,它与 Ryzen 处于同一水平(视模型不同领先 4% 至 15%)。在小型稠密模型上,Mac M5 Max 的生成速度约为其两倍:119.9 对 59.4 tok/s(每秒 token 数)。
有三类机器可为本地 AI 提供 128 GB 内存:NVIDIA 的 GB10(GIGABYTE 的 AI TOP ATOM 即其中一款)、AMD 的 Ryzen AI Max+ 395(代号 Strix Halo)以及 Apple 的 Mac M5 Max。我们测量了由 GIGABYTE 免费提供的 AI TOP ATOM,所用命令与另外两者已发布测量的命令相同,并注明了软件版本和日期。以下是各自的优势所在,以及哪种用途适合购买哪一款。
#我们如何比较这三台机器?
为了将 Ryzen AI Max+ 395 和 Mac 的公开基准数据与 ATOM 的测量结果进行比较,我们完全沿用了已发布测量的格式。第一项测试让机器读取 512 个 token(token 是词的一个片段),然后生成 128 个(即 llama-bench 中的“pp512”和“tg128”;llama-bench 是 llama.cpp 的测量工具,而 llama.cpp 是一个广泛用于本地模型的开源推理引擎)。
该测试已在 llama.cpp 第 4167 号讨论帖中针对 Mac M5 Max 公布,并由独立贡献者 kyuz0 针对配备 Ryzen AI Max+ 395 和 128 GB 内存的 Framework Desktop 公布。第二项测试测量的是内存中已有 32,768 个 token 时的速度。它来自 llama.cpp 第 16578 号讨论帖,kyuz0 也公布了 Ryzen 的该项结果。
我们的测试方案于 2026 年 10 月 6 日 13:30 定稿,早于首次测量。同日 23:45 的一份补充条款增加了这一对比格式。
512 个 token 读取和 128 个 token 生成的测量于 10 月 7 日 22:38 进行:每个模型重复五次,llama.cpp 构建版本 11430,与 kyuz0 的测量一样启用了快速注意力(Flash Attention),机器上没有运行其他任务。32,768 个 token 的测量于 10 月 6 日进行。测试方法、文件哈希以及表格数据均发布在我们的方法说明页面上。
速度单位为每秒 token 数(tok/s)。token 是单词的片段:在法语中,一个 token 约相当于三分之二个单词。内存容量以 GB 为单位(1 GB = 1,024 MB,与 Linux 显示方式一致);以 GB/s 表示的内存带宽为厂商标称值,采用十进制单位。以下是在 ATOM 上使用的命令:
需要注意:构建版本(build)是 llama.cpp 的版本号,而三台机器使用的版本并不相同。Ryzen 于 2026 年 5 月使用 b9187 或 b9193 构建版本测量,Mac 于 8 月使用 b10621 测量,ATOM 于 10 月使用 b11430 测量。
更新的构建版本可能会更快。为保持公正,对于 32,768 个 token 的测试,我们也给出了使用 2026 年 2 月构建版本 7941 的数据,该版本比 Ryzen 所用的版本更旧(Mac 在此规格下没有公开的测量数据)。
#三台 128 GB 机器:有何不同?
借助我们的经验和引导式路径,选择适合你 Mac 的工具,在日常中使用你的 AI。
- 在线空间,终身可用
- PDF + 文件
- 30 天内退款
NVIDIA 的 GB10 集成了 20 个 Arm 核心和一颗 Blackwell GPU,配备 128 GB 统一内存(由处理器和 GPU 共享),标称带宽为 273 GB/s。AMD 的 Ryzen AI Max+ 395(代号 Strix Halo)同样由处理器和 GPU 共享 128 GB 内存,理论带宽约 256 GB/s。Apple 的 M5 Max 最高支持 128 GB,带宽 614 GB/s,GPU 为 40 核。
| 机器 | 芯片 | 内存 | 带宽 |
|---|---|---|---|
| AI TOP ATOM(GIGABYTE) | NVIDIA GB10:20 个 Arm 核心和 Blackwell GPU | 128 GB LPDDR5x | 273 GB/s |
| Ryzen AI Max+ 395(在 Framework Desktop 上发布的数据) | AMD Strix Halo | 128 GB LPDDR5x | 约 256 GB/s(理论值) |
| Mac M5 Max | Apple M5 Max:40 核 GPU | 最高 128 GB | 614 GB/s |
每生成一个 token,芯片都要从内存中重新读取模型的活跃权重(此刻用到的参数):因此生成速度取决于内存带宽,而一次处理大量 token 的读取速度则取决于 GPU 的算力。
GB10 与 Ryzen 的带宽相近,生成速度也相近。M5 Max 的带宽是 ATOM 的 2.25 倍(614 对比 273 GB/s):在唯一公开的稠密模型 llama 7B 上,其生成速度约快两倍。
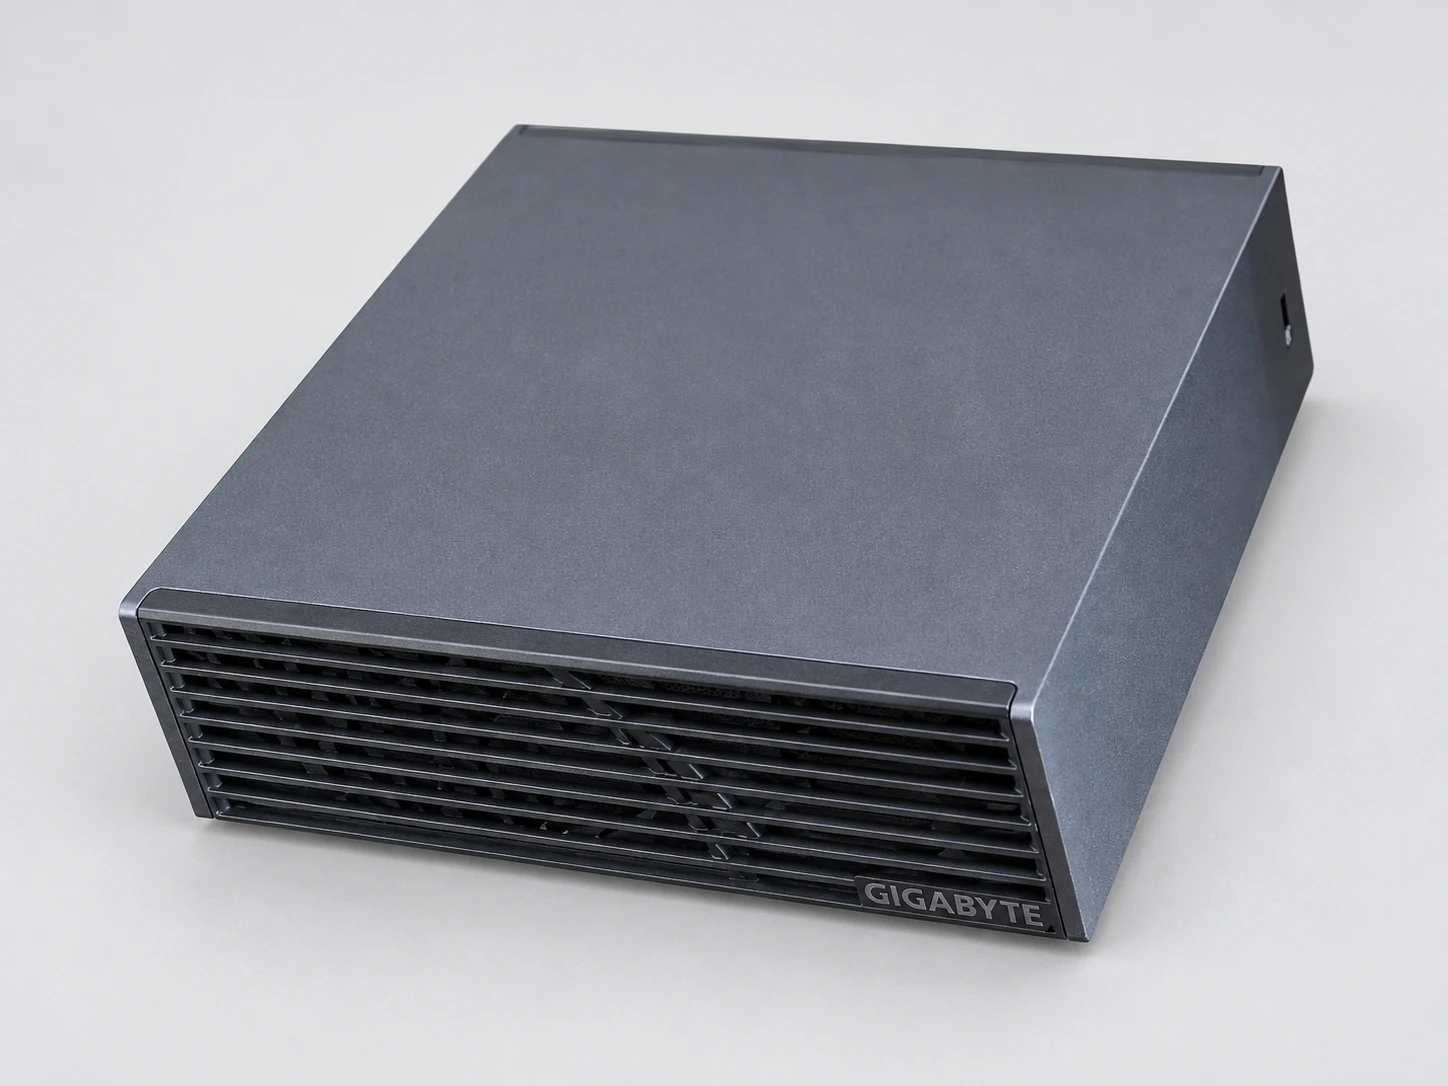
据我们所知,所有 128 GB 的 GB10 机器都采用相同的 NVIDIA 芯片。因此,本指南中的速度反映的是该平台的性能。GIGABYTE 额外提供的是一升容积的机箱(1.2 kg)、散热、做工以及商业型号。
为了验证我们的这台机器确实达到了该平台应有的速度,我们复现了 llama.cpp 项目为 NVIDIA 的 DGX Spark(该平台的参考机型)发布的表格(构建 7941,2026 年 2 月)。在六个模型、60 个测量点上,我们的读取速度偏差中位数为 +0.3%(范围 −1.8% 至 +2.3%),生成速度偏差中位数为 −2.8%(范围 −4.3% 至 −0.3%):两台机器处于同一水平。
#谁读取得最快?
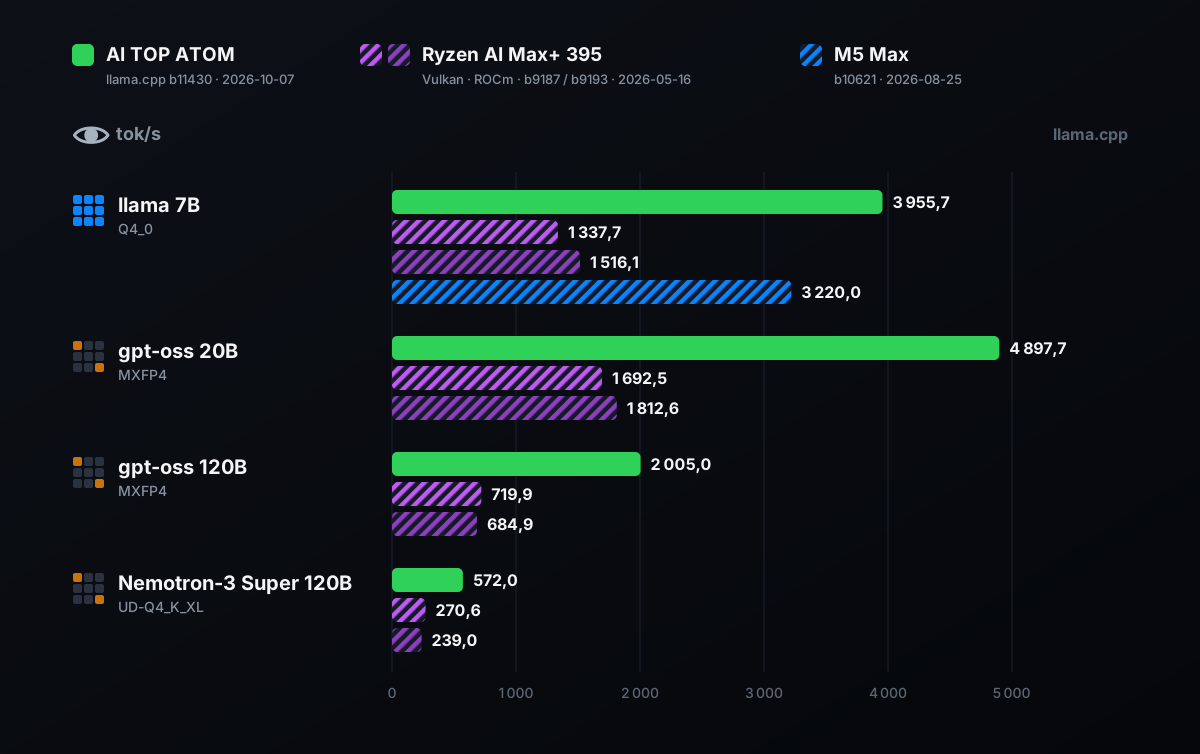
读取是 ATOM 的强项。表格列出了我们能够严格对比的四个模型,即每台机器使用相同的模型和相同的量化。“llama 7B”指 70 亿参数的 Llama 2,是这些公开数据中的参考模型:它是稠密模型(每个 token 都使用全部参数),而其余三个是 MoE 模型(只激活其中一部分参数)。
| 模型 | AI TOP ATOM | Ryzen,Vulkan | Ryzen,ROCm | Mac M5 Max | ATOM / 最佳 Ryzen |
|---|---|---|---|---|---|
| llama 7B (Q4_0) | 3 955,7 | 1 337,7 | 1 516,1 | 3 220,0 | × 2,6 |
| gpt-oss 20B(MXFP4) | 4 897,7 | 1 692,5 | 1 812,6 | — | × 2,7 |
| gpt-oss 120B(MXFP4) | 2 005,0 | 719,9 | 684,9 | — | × 2,8 |
| Nemotron-3 Super 120B(UD-Q4_K_XL) | 572,0 | 270,6 | 239,0 | — | × 2,1 |
在这四个模型上,ATOM 的读取速度是 Ryzen AI Max+ 395 两种软件栈中较优者的 2.1 到 2.8 倍(Vulkan 和 ROCm 是让 AMD GPU 执行计算的两种方式)。在 gpt-oss 120B 上,它每秒读取 2,005 个 token:一个 2,000 token 的提示词(约 1,300 个单词)一秒即可处理完毕。
与 Mac 相比,我们只有一个以 llama-bench 格式公布的对比点:llama.cpp 第 4167 号讨论帖中针对 Apple 芯片的参考模型,即 Q4_0 量化的 llama 7B(70 亿参数的 Llama 2)。ATOM 在该模型上每秒读取 3,955.7 个 token,而 M5 Max 为 3,220.0:高出 23%。
使用 Ollama(一款在本地运行模型的工具),在一份约 17,000 token 的文档上,我们本系列的第一篇指南测得 ATOM 在 gpt-oss 120B 上为 1,816 tok/s,而一位读者测得的 MacBook Pro M5 Max 为 1,388,所用文本相近但不完全相同(ATOM 为 16,850 token,Mac 为 16,689 token):高出 31%。
为什么 ATOM 读取得这么快?读取主要是计算,而 GB10 的 Blackwell GPU 拥有专用于 AI 计算的核心(NVIDIA 的“Tensor Cores”)。对于一份五十页的报告、一个代码仓库,或每次回答前都要重读历史记录的智能体来说,这正是关键指标。
解读时有两点需要注意。首先,build 版本不同(Mac 为 10621,ATOM 为 11430):请将 23% 的差距视为量级参考。其次,两个最小的模型(llama 7B 和 gpt-oss 20B)在每次重复之间会有 3% 至 5% 的波动,因为该测试仅持续约十分之一秒。不过,两组独立测试的平均值相差不到 1%:llama 7B 为 3,955.7 和 3,920.2,gpt-oss 20B 为 4,897.7 和 4,905.2。
#谁生成得最快?
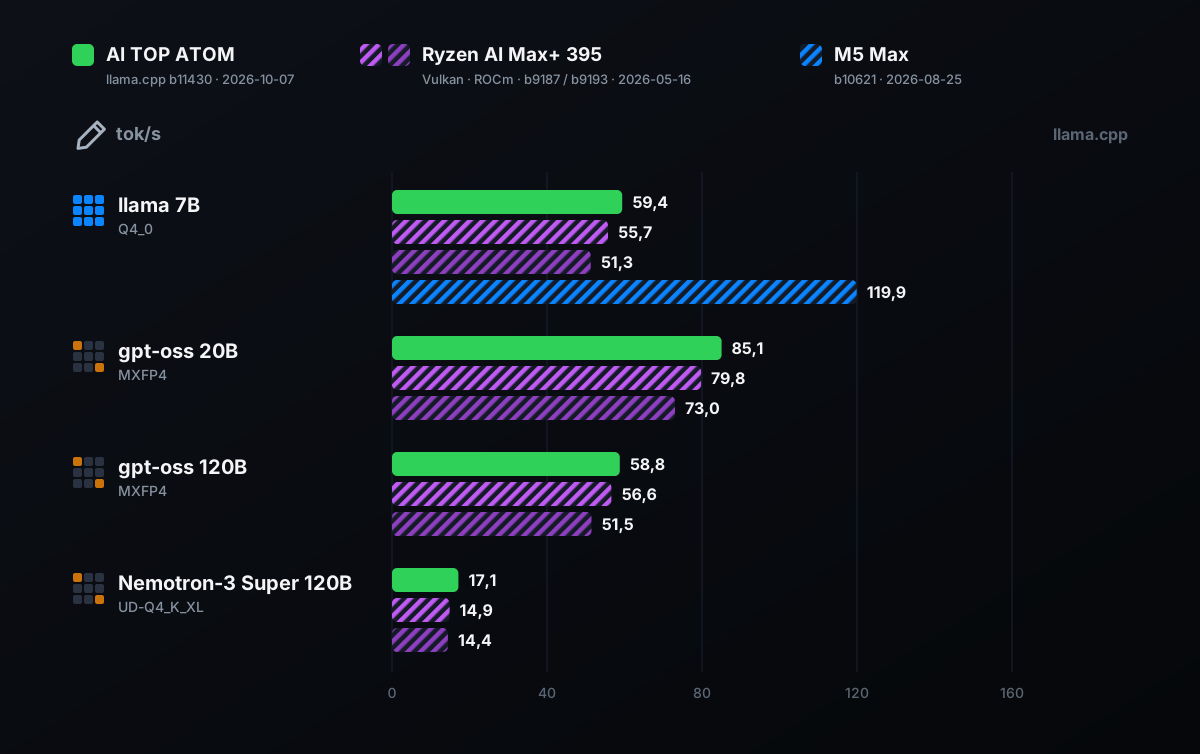
生成速度是回答的输出节奏。它取决于内存带宽,而内存带宽因机器而异。
| 模型 | AI TOP ATOM | Ryzen,Vulkan | Ryzen,ROCm | Mac M5 Max | ATOM / 最佳 Ryzen |
|---|---|---|---|---|---|
| llama 7B (Q4_0) | 59,4 | 55,7 | 51,3 | 119,9 | +7 % |
| gpt-oss 20B(MXFP4) | 85,1 | 79,8 | 73,0 | — | +7 % |
| gpt-oss 120B(MXFP4) | 58,8 | 56,6 | 51,5 | — | +4 % |
| Nemotron-3 Super 120B(UD-Q4_K_XL) | 17,1 | 14,9 | 14,4 | — | +15 % |
与 Ryzen AI Max+ 395 的最佳软件栈相比,ATOM 在三个模型上的生成速度快 4% 至 7%,在 Nemotron-3 Super 120B 上快 15%。两者水平接近:两种内存的带宽相近,且 build 版本不同。
在拥有 1170 亿参数的 gpt-oss 120B 上,ATOM 生成 128 个 token 时速度为每秒 58.8 个(在我们的第一篇指南中,生成 32 个 token 时为 58.0 个),用于对话非常流畅;Ryzen 最高为每秒 56.6 个。
Mac M5 Max 生成更快,在小型稠密模型上约快两倍(每秒 119.9 个 token 对比 59.4 个),这得益于其 614 GB/s 的内存,是 ATOM 的 2.25 倍。
在稠密模型上,软件可以加快生成速度。借助一个小型“草稿”模型提出 token,再由大模型一次性验证(即推测解码),Llama 3.3 70B 在 ATOM 上处理法语文本时从每秒 4.7 个 token 提升到 12 个(提前 8 个词),处理代码时最高可达 18.7 个(提前 16 个词):速度提升 2.6 到 4 倍(llama-server b11430,草稿模型 Llama 3.2 1B,6日和2026年10月7日)。这项技术在其他机器上同样可用,但我们尚未在这些机器上进行测量。
#处理长文档时会怎样?
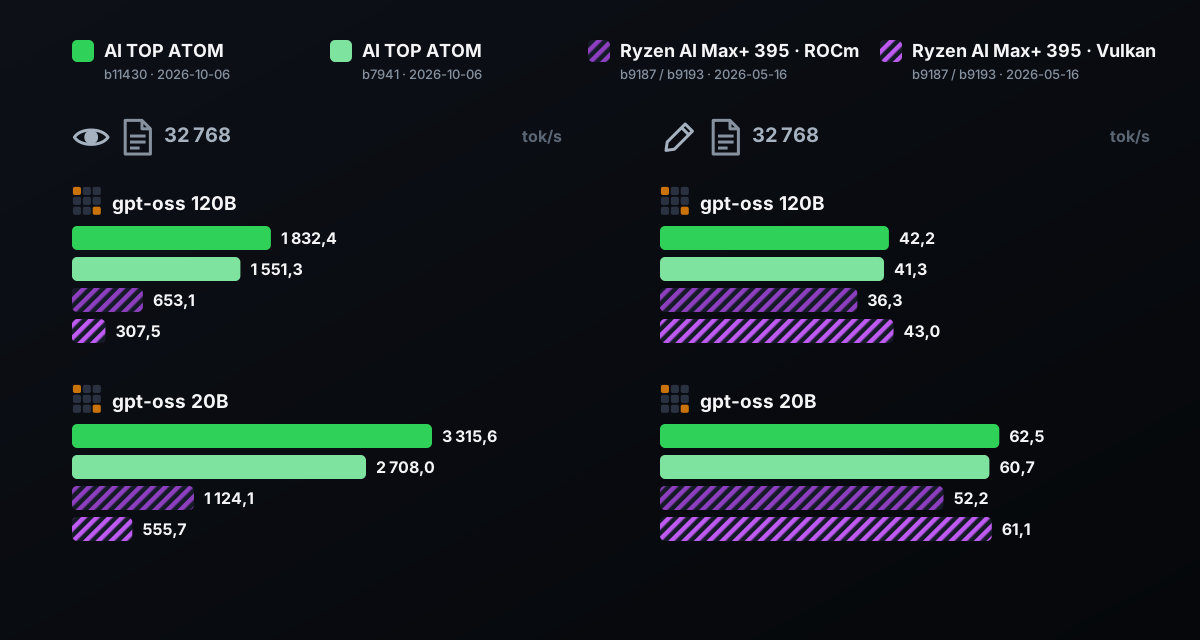
已有文本越长,后续生成越慢。大上下文测试测量的是内存中已有 32,768 个 token(约五十页)时的读取和生成速度。表格在两个 gpt-oss 模型上比较 ATOM 与 Ryzen AI Max+ 395,其中 ATOM 使用了两个构建版本。据我们所知,Mac 尚无同一格式的公开测量数据。
| 模型 | 机器与软件栈 | 32,768 时的读取 | 32,768 下的生成 |
|---|---|---|---|
| gpt-oss 120B | AI TOP ATOM,构建版本 11430 | 1 832,4 | 42,2 |
| gpt-oss 120B | AI TOP ATOM,build 7941 | 1 551,3 | 41,3 |
| gpt-oss 120B | Ryzen AI Max+ 395,ROCm | 653,1 | 36,3 |
| gpt-oss 120B | Ryzen AI Max+ 395,Vulkan | 307,5 | 43,0 |
| gpt-oss 20B | AI TOP ATOM,构建版本 11430 | 3 315,6 | 62,5 |
| gpt-oss 20B | AI TOP ATOM,build 7941 | 2 708,0 | 60,7 |
| gpt-oss 20B | Ryzen AI Max+ 395,ROCm | 1 124,1 | 52,2 |
| gpt-oss 20B | Ryzen AI Max+ 395,Vulkan | 555,7 | 61,1 |
使用 gpt-oss 120B 时,在 32,768 token 上下文下,ATOM 每秒读取 1,832 个 token:比 ROCm 下的 Ryzen AI Max+ 395(653)快 2.8 倍,比 Vulkan 下(308)快 6 倍。使用比 Ryzen 所用版本更旧的 build 7941,领先幅度仍为 2.4 倍和 5 倍。使用 gpt-oss 20B 和 build 11430,领先幅度为 2.9 倍和 6.0 倍。
在 32,768 token 下的生成方面,ATOM(在 gpt-oss 120B 上为 42.2 tok/s)与 Ryzen 的最佳软件栈(Vulkan 下 43.0)持平,并领先另一软件栈(ROCm 下 36.3)。因此结论很简单:处理长文档时,AMD 的机器使用其最佳软件栈(Vulkan 下 43.0)生成速度同样快,但读取该文档所需的时间是 ATOM 的 2.8 至 6 倍。
实际使用中,借助 llama-server(llama.cpp 的服务器),我们的 ATOM 使用 gpt-oss 120B 在 21.8 秒内读完一份 30,000 token 的文档,随后以每秒 42.8 个 token 的速度生成回答(本系列第一篇指南的测量结果)。
#多用户场景下又如何?
当多人或多个智能体(独立工作的 AI 程序)同时向机器发出请求时,vLLM 之类的服务器会将这些请求合并,所有请求只需读取一次模型权重。此时带宽不再是唯一的瓶颈:GB10 的算力接过了主导。
在我们的第一篇指南中,gpt-oss 120B 从单人的 35.6 tok/s 提升到 16 人合计 160.3 tok/s,每人仍能获得 10.2 tok/s。gpt-oss 20B 从 49.1 提升到合计 322.4 tok/s,每人 20.7 tok/s(vLLM 26.09,2026 年 10 月 6 日)。
持续表现与峰值同样重要。在 16 个用户并发运行 1 h 的测试中(请求 4,096 个 token,回答 512 个),gpt-oss 120B 从头到尾保持在总计每秒 124.8 个 token:14 个测量区间内介于 122.6 至 128.1 之间,即漂移为 0.0%,GPU 最高 77 °C,且未出现降频。
在 Llama 3.3 70B(NVFP4 格式,一种 NVIDIA 的压缩格式)上以 8 名用户持续运行 2 小时,总吞吐量从每秒 38.7 个 token 变为 38.5 个(−0.6%)。
StorageReview 在 AMD Ryzen AI Halo 机器(属于 Ryzen AI Max 系列)上使用 vLLM 测量了同类负载,并与 DGX Spark 对比。在大多数高并发场景中,AMD 机器落后 2 到 4 倍;在一项使用 gpt-oss 120B 的高读取负载测试中,落后多达 8.8 倍。DGX Spark 与 ATOM 采用同一芯片;这些 Ryzen 数据来自 StorageReview 的测试。
#CUDA 会带来哪些变化,尤其是在训练方面?
CUDA 是 NVIDIA 用于在其 GPU 上进行计算的软件平台。在 ATOM 上,基于 DGX OS 7.5.0(CUDA 13.0,驱动 580.159.03),为该芯片编译的 llama.cpp、NVIDIA 提供的容器中的 vLLM 以及 Unsloth 在我们的测试中均可正常运行。据我们所知,许多 AI 工具最先是为 CUDA 编写的:这对部署模型和训练模型都是一项优势。
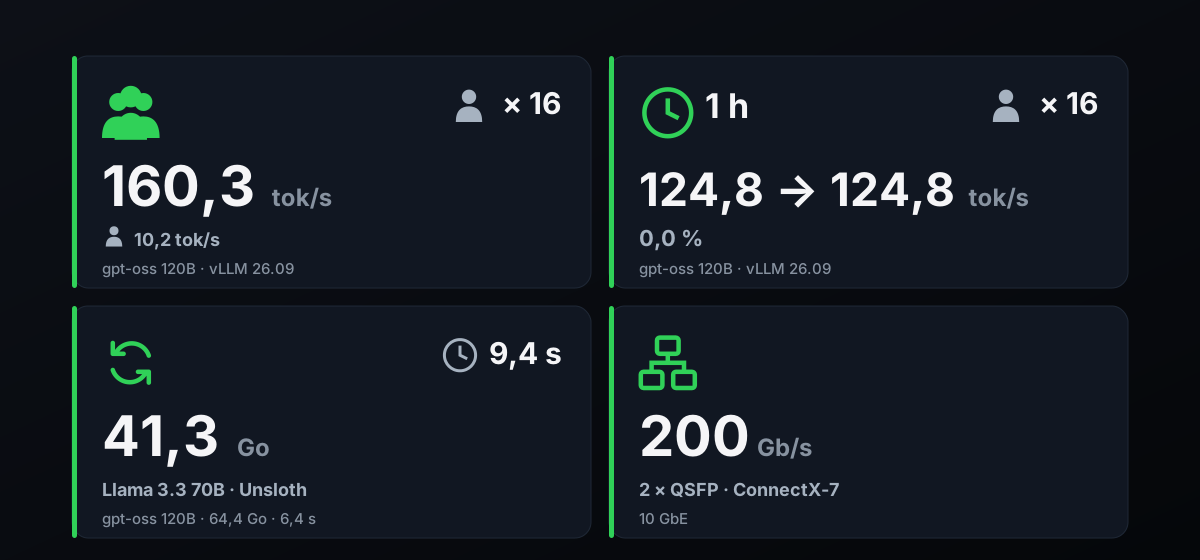
训练方面,NVIDIA 宣称该平台可对最高 700 亿参数的模型进行微调。我们使用 Unsloth 2026.10.1 和 QLoRA 方法(一种使用 4 位压缩权重的微调)测量了两种情况,序列长度为 1,024 个 token,共 40 步,其中前 10 步用于预热。
Llama 3.3 70B 的 GPU 内存峰值占用为 41.3 GB,每步耗时 9.4 秒。gpt-oss 120B 需要 64.4 GB,每步 6.4 秒。因此,这一规模的两个模型都能在 ATOM 的内存中完成训练,并且留有余量。
一个具体案例:在 Qwen3-8B 上进行一次耗时 85 分钟的轻量级 LoRA 微调(一个 epoch,2,000 个样本)后,在 200 份从未见过的文档上、采用严格评分标准,完全无误提取的发票比例从 26.0% 提升到 95.0%。这优于未经训练的 gpt-oss 120B(62.5%)。这些发票均为虚构,由我们自行生成。本系列中专门介绍微调的指南详细说明了具体方法。
此外,这台机器还配有两个 QSFP 端口(ConnectX-7 网卡,据 GIGABYTE 称为 200 Gb/s)和一个 10 GbE 端口。据 GIGABYTE 称,最多可将四台 GB10 机器连接成集群;我们未测试过这种配置。
#这三台机器分别多少钱?
含税价格于 2026 年 10 月 8 日在法国各商家页面上记录。GB10 的价格每周都在变动:购买前请核实。
| 机器 | 配置 | 含税价 | Marchand |
|---|---|---|---|
| GMKtec EVO-X2(Ryzen AI Max+ 395) | 128 GB,2 TB SSD | 3 449,99 € | gmktec.fr |
| Minisforum MS-S1 MAX(Ryzen AI Max+ 395) | 128 GB,2 TB SSD | 4 159,00 € | minisforumpc.fr |
| AI TOP ATOM ATAGB10-9001 | 128 GB,SSD 4 TB PCIe 4.0 | 6,346.27 欧元(10 月 8 日售罄) | AORUS 官方商店(Amazon.fr 有货) |
| MSI EdgeXpert(GB10) | 128 GB,SSD 4 TB | 6,599.95 欧元(10 月 8 日缺货) | Materiel.net |
| AI TOP ATOM ATAGB10-9000 | 128 GB,SSD 4 TB PCIe 5.0 | 7,999.95 欧元(10 月 8 日缺货) | LDLC、Materiel.net |
| Mac Studio M5 Max(18 核 CPU,40 核 GPU) | 128 GB,SSD 512 GB | 5 859 € | apple.com/fr |
| Mac Studio M5 Max(18 核 CPU,40 核 GPU) | 128 GB,SSD 4 TB | 7,839 欧元(计算值) | apple.com/fr,存储选项 |
Ryzen AI Max+ 395 是最便宜的机器。在同为 4 TB 存储的情况下,ATOM 9000(PCIe 5.0 SSD,即我们实测的版本)与 Mac Studio M5 Max 处于同一价格区间。ATOM 9001 配备 PCIe 4.0 SSD,是表中最便宜的 128 GB GB10 机器;据我们所知,它采用相同的芯片和相同的内存。
SSD 主要影响模型的加载时间,而不影响其计算速度;SSD 相关数据均针对 9000 版本。我们也列出了 Mac Studio M5 Max 的价格,因为它使用与公开数据中实测机器相同的芯片;本指南未测量其速度。
两款 ATOM 的区别在于其一升容积(1.2 kg)的机身以及 GIGABYTE 的设计取舍:散热、做工和型号。
#本对比未涵盖的内容
- 测量数据来源
- Ryzen AI Max+ 395(一台 128 GB 的 Framework Desktop)和 Mac M5 Max 的数据来自公开资料,并附有构建版本和日期;价格表中的迷你主机未经测量。差距小于 10% 的结果应视为持平:构建版本会变化,同一型号的两台机器之间也会相差几个百分点。
- Apple 的 MLX 引擎未经测量
- 在 Mac 上,MLX 的速度可能与 llama.cpp 或 Ollama 不同。我们的《MLX 与 llama.cpp 对比》指南详细介绍了这一差异。
- 与 Mac 仅有一个共同模型
- 针对 M5 Max 公开的 llama-bench 格式数据仅涵盖 llama 7B。对于大模型,我们只有一位读者提供的 Ollama 测量结果。
- 回答质量
- 本指南比较的是速度,而不是模型质量。
- 其他机器上的多用户与训练
- 我们既没有在 Ryzen 上、也没有在 Mac 上测量这些项目。Ryzen 的数据引自 StorageReview。
更新与更正:如果 llama.cpp 的新构建版本或新的公开数据改变了这些结果,本页将进行修订;每次更正都会注明日期。
#谁适合选择 ATOM
以下内容来自我们在 ATOM 上的测量结果以及上文引用的公开数据。
- 如果您要读取长文档或代码,ATOM 是正确的选择
- 在内存中已有 32,768 个 token 时,它读取 gpt-oss 120B 的速度是 Ryzen AI Max+ 395 的 2.8 倍,并能在 21.8 秒内读完一份 30,000 token 的文档。
- ……如果多人或多个智能体共用这台机器
- 使用 gpt-oss 120B 时,16 名用户合计每秒 160.3 个 token;在请求更长的情况下,吞吐量在 1 小时内保持在每秒 124.8 个 token,没有下降。
- ……如果您要训练或适配模型
- 对 700 亿参数模型进行 QLoRA 只需 41.3 GB。在发票数据上进行一次 LoRA 耗时 85 分钟。
- ……如果您想在一升容积的机箱中运行大型 MoE 模型
- gpt-oss 120B 在一台 1.2 kg 的机器上每秒生成 58.8 个 token。
- 如果您是单人使用小型稠密模型进行生成,Mac M5 Max 更合适
- 它在 llama 7B 上的生成速度约快两倍(每秒 119.9 个 token 对比 59.4 个)。
- 如果预算是决定因素,Ryzen AI Max+ 395 迷你主机更合适
- 在 MoE 模型上生成速度相近,价格从 3,449.99 欧元起,但读取速度慢 2.1 至 2.8 倍。
总结:根据我们的对比,如果您的工作是读取长文本,ATOM 是正确的选择。若要为多人提供服务或进行训练,它自身的测量结果很扎实:16 名用户合计每秒 160.3 个 token,700 亿参数的 QLoRA 仅占用 41.3 GB。如果您独自使用小型稠密模型进行生成,可以考虑 Mac。如果预算是决定因素,可以考虑 Ryzen。
#FAQ
GB10、Ryzen AI Max+ 395 和 Mac M5 Max 中,哪台机器最快?+
AI TOP ATOM 比 Mac M5 Max 更快吗?+
为什么同一台机器的数据在不同网站上会不一样?+
如何将我自己的机器与这些数字进行比较?+
与 GB10 相比,Ryzen AI Max+ 395 是个好选择吗?+
有反馈、发现了错误,或想补充说明?请告诉我们,让这份指南对每个人都更有帮助。