AI TOP ATOM 与 DGX Spark:有哪些差异 实际的?
GIGABYTE AI TOP ATOM 和 NVIDIA 的 DGX Spark 均采用相同的 GB10 芯片和相同的 128 GB 内存。使用 llama.cpp 时,我们的测量结果与 DGX Spark 已发布数据的差异最多为 4.3%;使用 Ollama 时,差异最多为 2%。GIGABYTE 提供了自有机箱、与 Founders Edition 相同的一升尺寸、自有散热系统以及六个参考型号。在连续负载 2 小时期间,速度保持稳定,没有任何强制降速。
NVIDIA 的 DGX Spark 和 GIGABYTE 的 AI TOP ATOM 都基于同一块 GB10 芯片。究竟有哪些变化?对于由 GIGABYTE 免费提供的 AI TOP ATOM,我们重新运行了针对 DGX Spark 发布的三组测量,然后测量了它在 1 小时和 2 小时负载下的表现、温度和 SSD,并核验了其接口。我们将在后文介绍各型号的价格和购买建议。
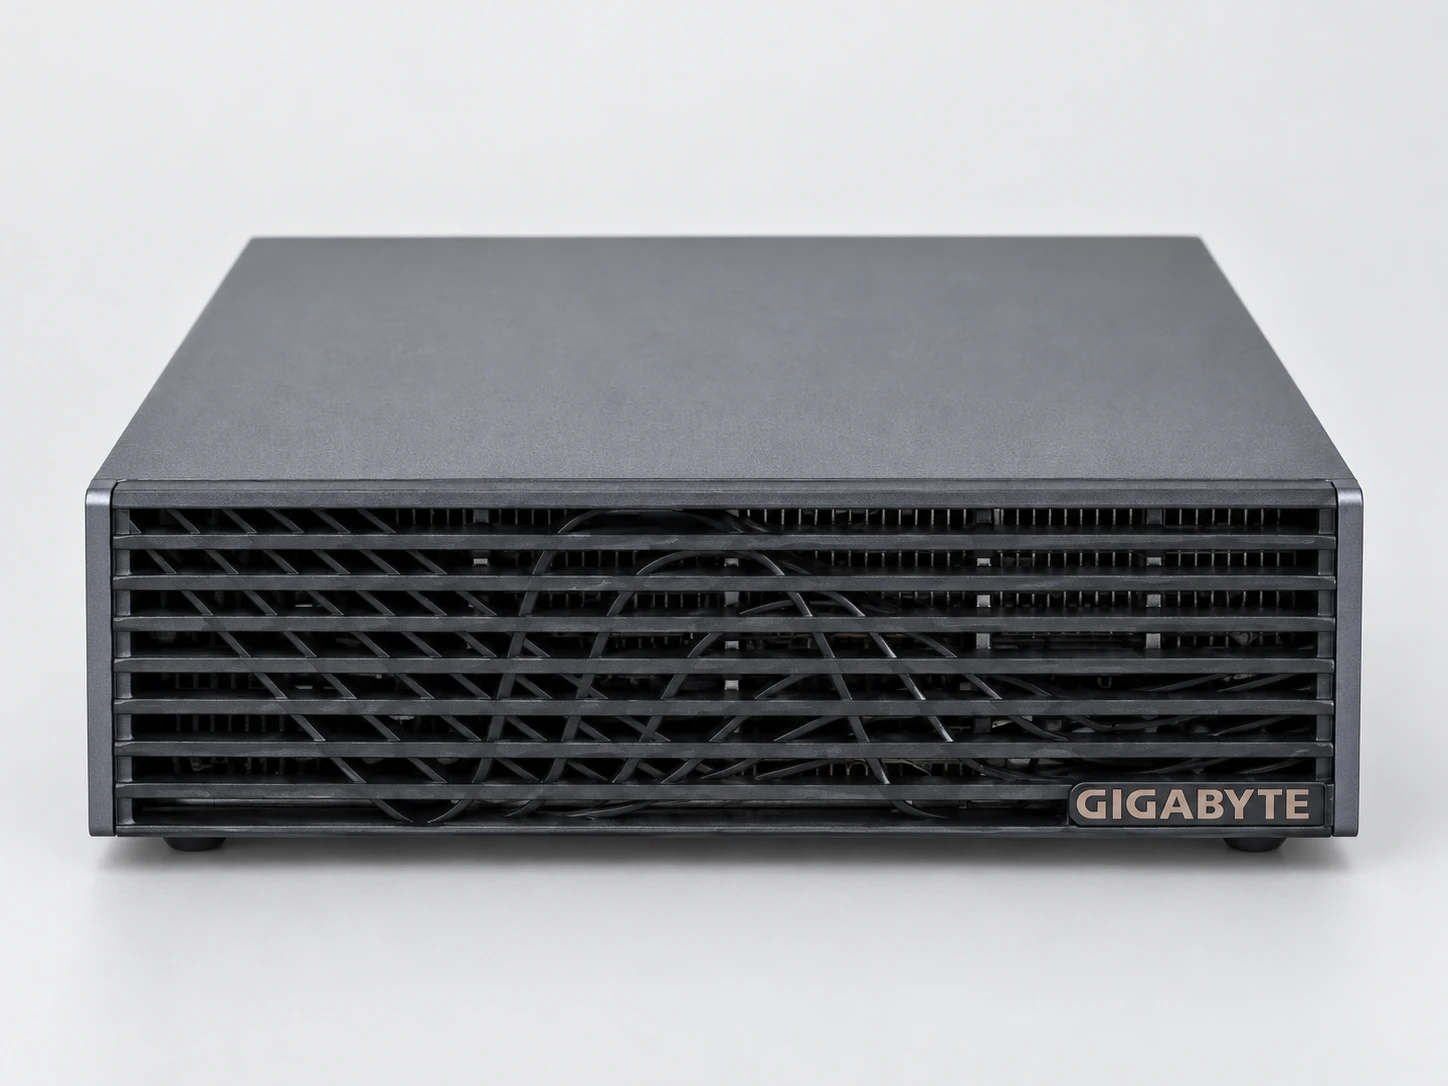
#相同的 NVIDIA GB10 芯片,GIGABYTE 制造
DGX Spark 是一个 NVIDIA 平台。其 GB10 芯片集成了 20 个 Arm 核心和一块 Blackwell 一代 GPU,共享 128 GB 内存,标称带宽为 273 GB/s。NVIDIA 还提供 DGX OS 系统、驱动程序和 CUDA。NVIDIA 销售的 DGX Spark 名为 Founders Edition。包括 GIGABYTE 在内的其他制造商,也提供基于同一平台的自有机器。
这一划分构成了整篇指南的框架。来自 NVIDIA 的部分适用于所有 GB10 机器:下一节将通过测量加以验证。来自 GIGABYTE 的部分则要从机箱、散热、存储、型号和保修等方面进行评判。美国硬件测试网站 StorageReview 写道,由于这些机器都共享相同的 GB10 基础平台,AI 性能差异仍然很小。
| 元素 | 提供方 | 在我们的 AI TOP ATOM 上 |
|---|---|---|
| GB10 芯片:20 个 Arm 核心,Blackwell GPU | NVIDIA | 速度与已发布数值相差不到 5%(下一节) |
| 128 GB 统一内存,273 GB/s | NVIDIA(平台) | 系统显示 121,7 GB;其中一部分为启动保留 |
| DGX OS、驱动程序、CUDA | NVIDIA | DGX OS 7.5.0,驱动程序 580.159.03,CUDA 13.0 |
| 尺寸为 150 × 150 × 50.5 mm,重量为 1.2 kg | 与 Founders Edition 相同的外形尺寸 | 哑光黑机箱,整面为无端口无按钮的鳍片式前面板 |
| 散热与做工 | GIGABYTE | 散热器、铜板、热管和两个风扇,据 ServeTheHome |
| SSD:容量和 PCIe 代际 | GIGABYTE(取决于型号) | 4 TB Samsung SSD,已验证为 PCIe 5.0(4 条通道上的 32 GT/s) |
| 240 W USB-C 供电 | GIGABYTE(附带适配器) | NVIDIA 要求使用随附的电源适配器 |
| 型号、价格、保修 | GIGABYTE 及经销商 | 查看参考信息和价格部分 |
#与 DGX Spark 相同的速度:三项核验
为了将 ATOM 与 DGX Spark 的参考数据进行比较,我们使用相同工具重新运行了针对该机器发布的三项测量。对于 llama.cpp 和 Ollama,版本和设置也完全相同;对于 vLLM,版本和命令并未公布。如果我们的 ATOM 得出相同数字,那么它就具备与该参考机相同的性能。
#方法与单位
llama.cpp 的每个速度都是 5 次重复测试的平均值,标准差低于 3%(标准差用于衡量重复测试的离散程度)。读取速度是机器在响应前接收您文本的速度。写入速度是响应显示出来的速度。
两者都以每秒 token 数(tok/s)衡量;token 是单词的一部分,在法语中约为一个单词的三分之二。内存和磁盘吞吐量以 Go 和 Go/s 表示,与 Linux 的显示方式一致:1 GB = 1 024 MB。
测试协议在第一次测量前已经固定。此后添加的每项测试都在测试前以带日期的修订说明进行描述。方法、带日期的修订说明列表以及我们表格中的数据,均发布在方法页面上。
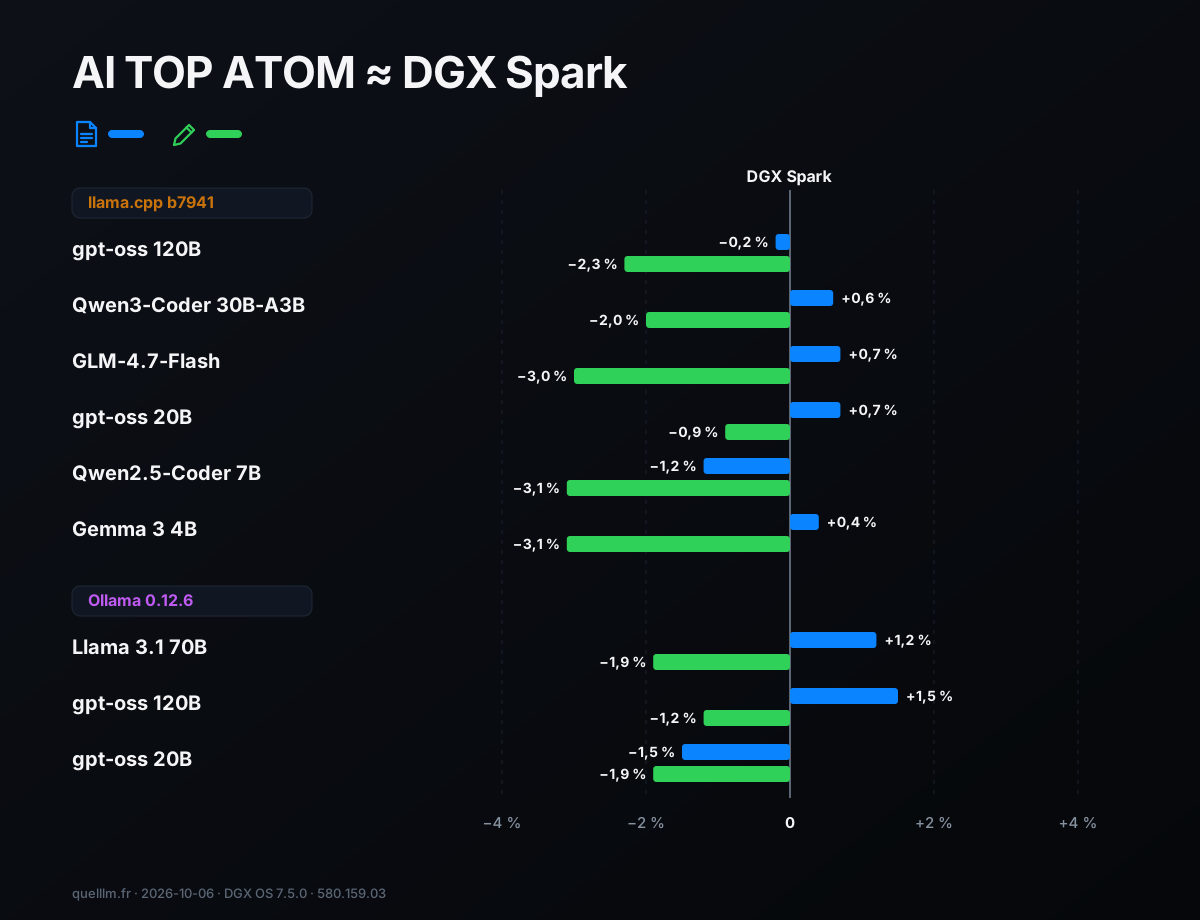
#使用 llama.cpp:误差不超过 4.3%
llama.cpp 是一种非常常用的开源引擎,用于在本地运行模型。该项目于 2026 年 2 月发布了 DGX Spark 的参考表,使用的是 build 7941(即软件版本号)。我们编译了相同的 build,并在六个模型和五种上下文深度上运行了相同的命令,共得到 60 个测量点。上下文是已经存在于内存中的文本:从 0 到 32 768 tokens。
结果是:读取速度几乎相同,差异不超过 2.3%,中位差为 +0.3%。写入速度也处于同一水平,中位差为 −2.8%(最多 4.3%)。对于 gpt-oss 120B,空上下文下的读取速度与基准相同:两边都是 2 443.9 tok/s。基准表使用的是比我们更旧的驱动程序(580.95.05),我们的版本是(580.159.03)。
#使用 Ollama 的官方脚本:相差 2% 以内
Ollama 于 2025 年 10 月发布了其对 DGX Spark 的测量结果,使用 0.12.6 版本和 580.95.05 驱动程序。我们使用相同的版本和相同的脚本,运行 10 次,温度设为 0。已发布的三个模型在读取和写入方面的结果差异均不超过 2%。
| 模型 | 读取:我们 / 已发布 | 差距 | 写入:我们 / 已发布 | 差距 |
|---|---|---|---|---|
| gpt-oss 20B | 3 175,0 / 3 224 | −1,5 % | 57,18 / 58,27 | −1,9 % |
| gpt-oss 120B | 1 186,8 / 1 169 | +1,5 % | 40,65 / 41,14 | −1,2 % |
| Llama 3.1 70B | 1 933,6 / 1 911 | +1,2 % | 4,34 / 4,423 | −1,9 % |
#使用 vLLM:同一数量级,不同引擎
StorageReview 于 2026 年 3 月 3 日使用 vLLM 测量了 ATOM;vLLM 是一款用于同时响应多人的服务器,测试在 gpt-oss 120B 上进行。StorageReview 没有公布 vLLM 的版本或确切命令。我们使用 vLLM 26.09,针对 1 名和 64 名用户重新运行了它的三个场景。
我们的吞吐量与其处于同一数量级,具体高低取决于场景。在单用户场景中,当机器读取 4 096 个 token 并写入 512 个 token 时,我们得到的总速率为每秒 304,4 个 token,而 StorageReview 的结果为 304,6。
在 64 个用户、均衡场景(读取 256 个 token,写入 256 个 token)下,我们达到 695 tokens/秒,而另一组为 650。由于 vLLM 版本不同,我们将这些数字视为同一数量级,而不是机器之间的比较。在这些测试期间,没有任何请求被中断。
总之,使用 llama.cpp 和 Ollama 这两个广泛用于本地运行的引擎时,ATOM 的性能与 DGX Spark 基本相同,差异不超过 5%。如需了解该芯片上各模型的速度,请参阅本系列的第一篇指南。
#GIGABYTE 提供的内容:机箱、散热和参考型号
AI TOP ATOM 的尺寸为 150 × 150 × 50,5 mm,重量为 1,2 kg,体积约一升:这就是 Founders Edition 的规格。机箱为哑光黑色。正面采用带波纹图案的条片结构,没有端口或按钮:所有设备都从背面连接。
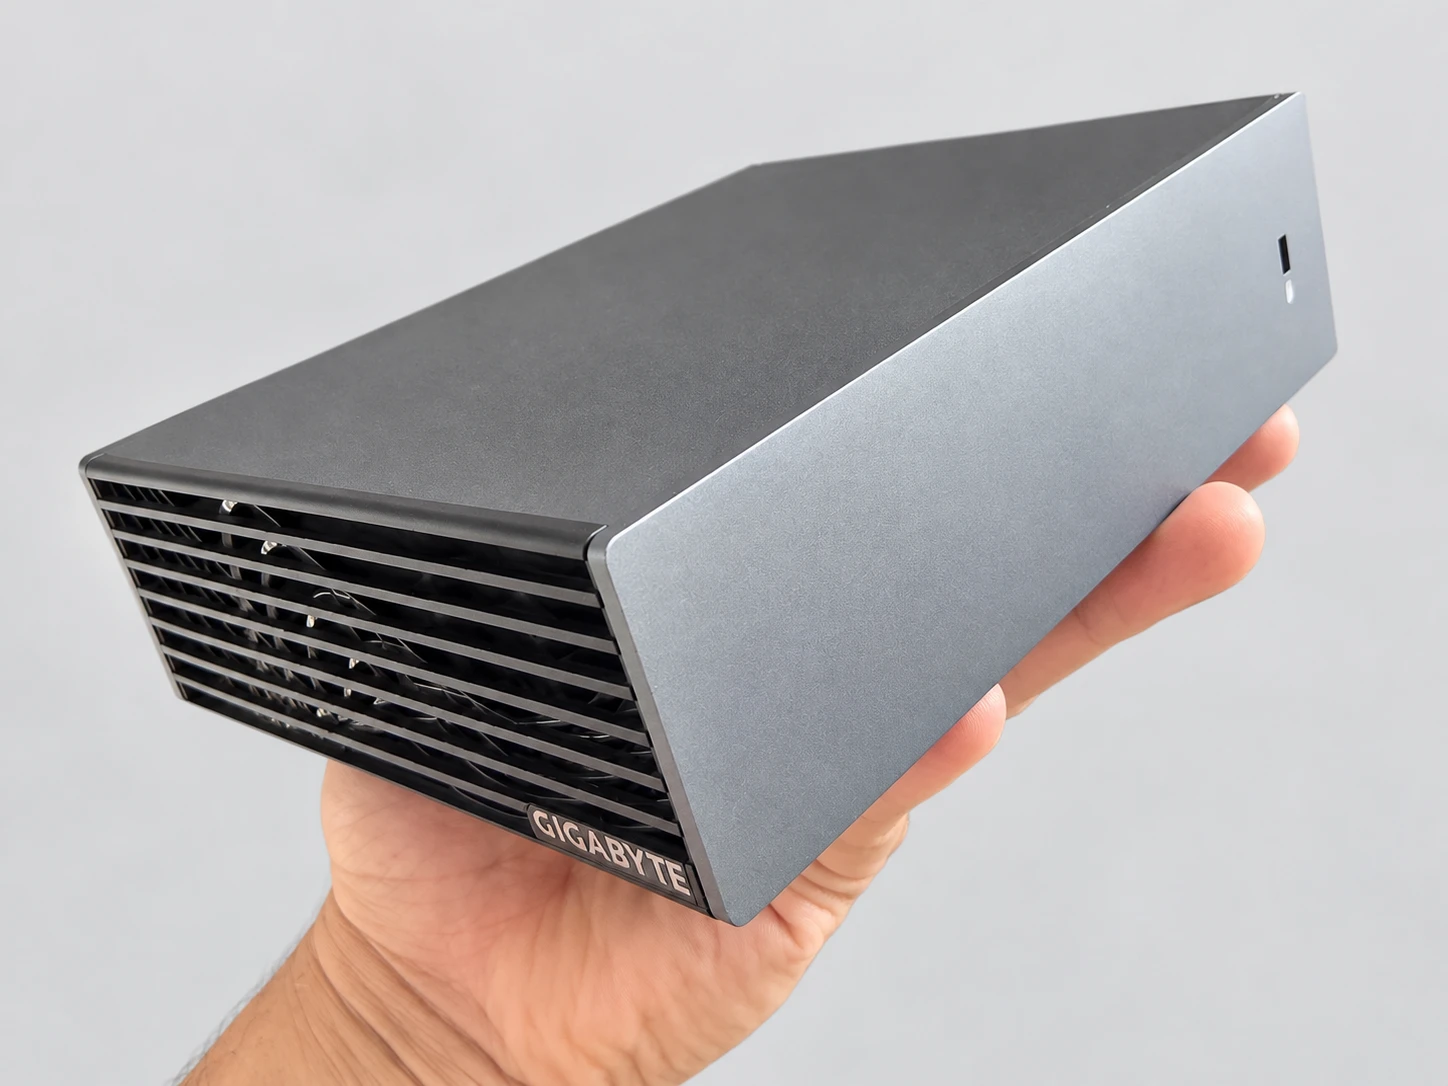
ServeTheHome 拆开了这台机器。它描述了一个大型散热器,芯片上覆盖着铜板和热管,并由两把 Delta 风扇冷却。StorageReview 于 2026 年 1 月比较了五台 GB10 机器。GIGABYTE 在峰值负载下最高达到 87 至 88 °C,与 Founders Edition 和 Dell 机器相同。
StorageReview 将其列入散热表现最佳的产品之列,其 GPU 功耗水平也位居前列。经过一个多小时的加热后,ServeTheHome 发现 ATOM 的表现达到 NVIDIA 的水平,并在其多项 AI 测试中略占优势。
自 2026 年 7 月起在大学实验室使用 ATOM 的 Peter Falkingham 在测试中称它几乎没有声音。
#六个参考型号,可任选一款 SSD
GIGABYTE 的产品页面列出了六个型号,从 ATAGB10-9000 到 ATAGB10-9005。表格列出了我们能够核实的型号。
| 参考 | 内存 | SSD |
|---|---|---|
| ATAGB10-9000(我们的设备) | 128 GB | PCIe 5.0 下的 4 TB |
| ATAGB10-9001 | 128 GB | PCIe 4.0 下的 4 TB |
| ATAGB10-9002 | 128 GB | PCIe 4.0 接口上的 1 TB |
| ATAGB10-9003 至 9005 | 128 GB 或 64 GB | PCIe 4.0 下的 2 TB 或 1 TB(未逐一核验型号) |
9000 使用的是 Samsung PM9E1 系列 SSD;根据 StorageReview,它与 Founders Edition 使用的是同一型号。这是一个 M.2 2242 模块。根据 ServeTheHome 的说法,这是用户唯一可以更换的组件。
#电源、包装盒与保修
240 W 适配器连接到专用于供电的 USB-C 端口。NVIDIA 要求使用随附电源,以获得最佳性能。包装盒内含机器、适配器和电源线。用于连接两台机器的 QSFP 线缆由 GIGABYTE 另行销售:AORUS 官方商店含税价为 94,04 €(2026 年 10 月 8 日记录)。
关于保修,GIGABYTE 手册指出,期限会在产品网站或产品标签上注明。LDLC 宣称 9000 提供 5 年保修(2026 年 10 月 8 日记录)。购买前请在经销商的产品页面上查看期限。
#接口与连接
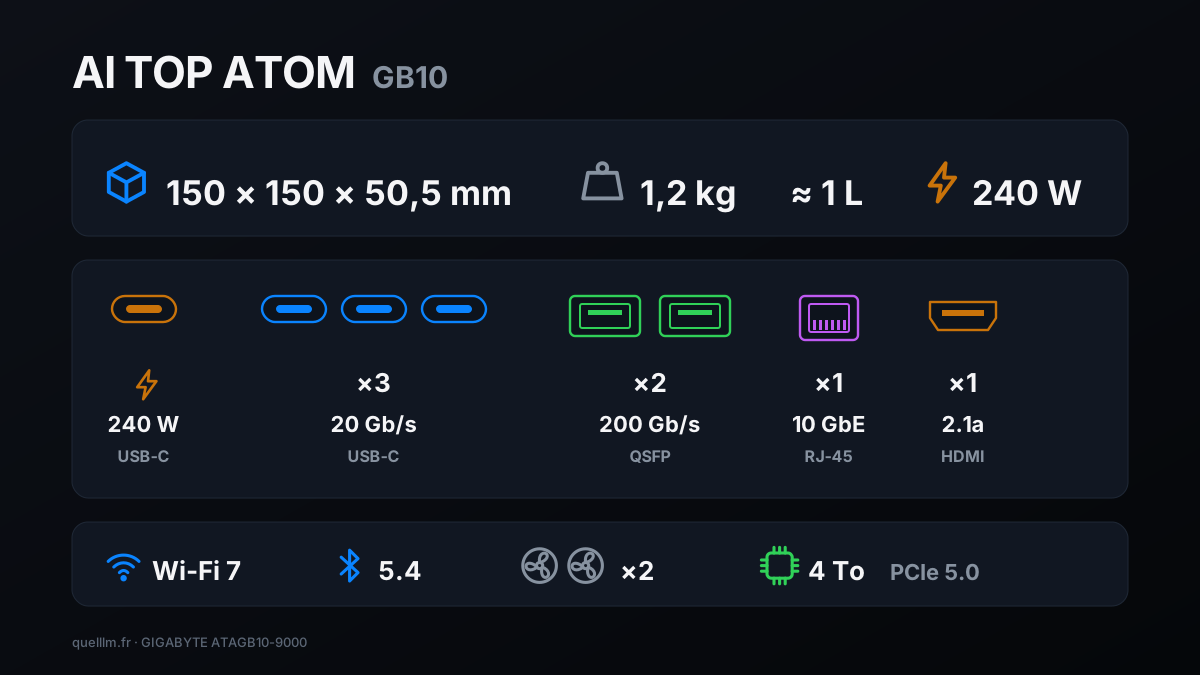
该列表采用 GIGABYTE 的资料,而 NVIDIA 的 Founders Edition 资料显示了相同的端口。在我们的设备上,我们核验了有线网络和 SSD 链路,并确认了 Wi-Fi 模块。
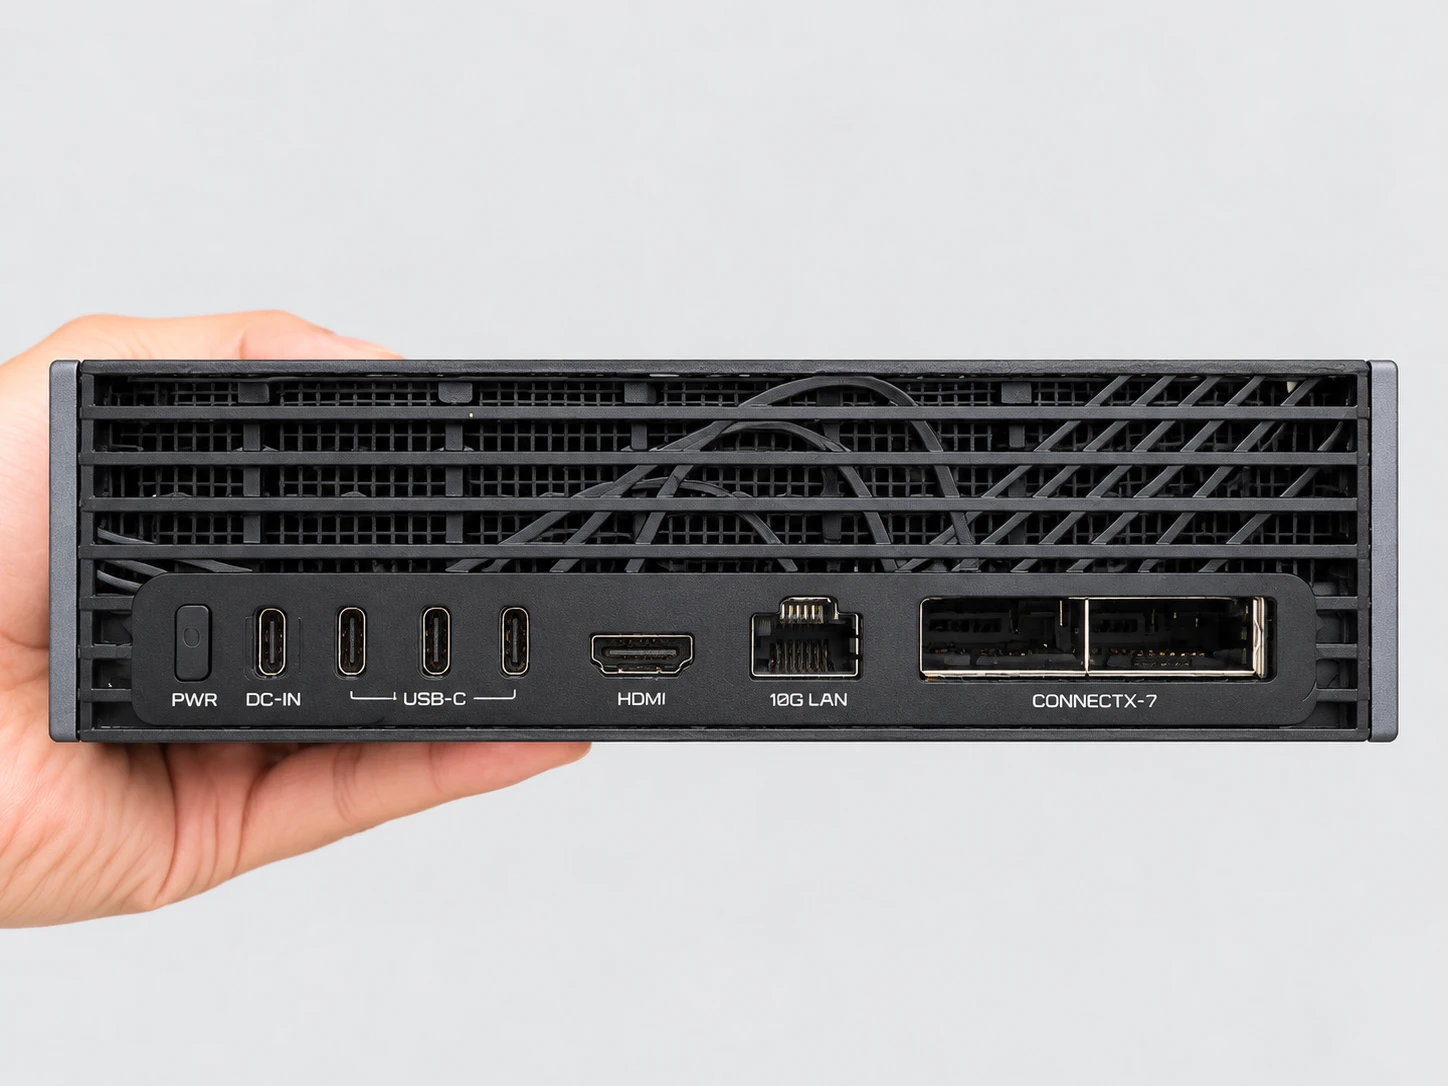
- 电源
- 一个专用于供电的 USB-C 接口,随附 240 W 电源适配器。
- USB
- 三个速率为 20 Gb/s 的 USB-C 接口(USB 3.2 Gen 2x2),用于连接磁盘和配件。
- 有线网络
- 一个 RJ-45 10 GbE 接口。在我们的设备上,协商出的链路速率为 10 Gb/s。
- 高速网络
- 两个 QSFP 端口(NVIDIA ConnectX-7 网卡,200 Gb/s),用于连接多台机器。我们没有测试该连接。
- 视频
- 一个 HDMI 2.1a 输出接口,支持多声道音频。
- 无线
- Wi-Fi 7 和 Bluetooth 5.4。我们的系统识别出一块 MediaTek MT7925 芯片。
#持续负载:连续 1 小时和 2 小时
紧凑型机器必须能够持续承受负载而不降速。由温度或功率上限导致的降速称为限频。我们使用 vLLM 26.09 让 ATOM 不间断运行。每次测试都分成多个时间片:一个时间片是一批紧接着上一批发送的请求。在此期间,我们每秒记录 GPU 时钟频率、功率、温度,以及驱动程序报告的限频原因。
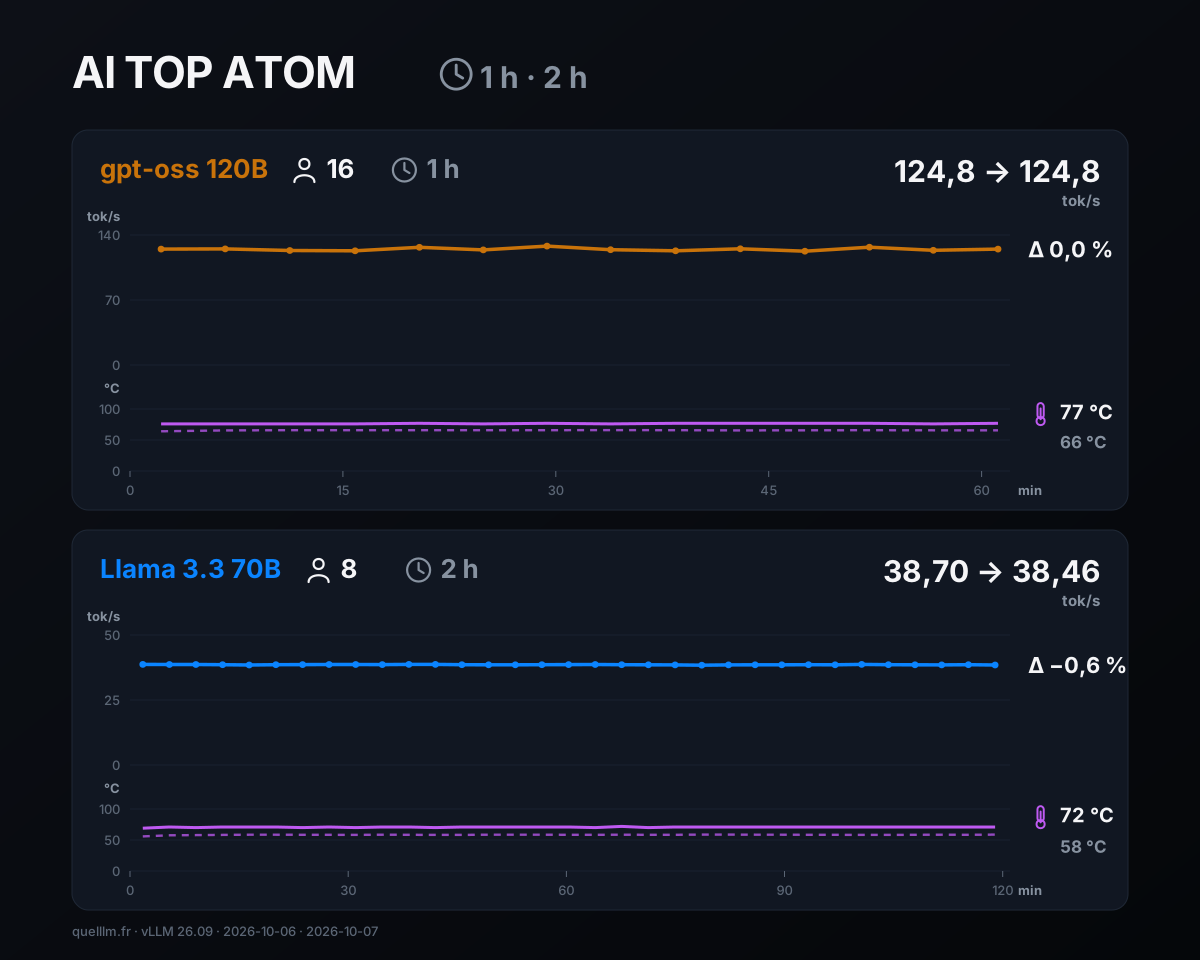
| 会话 | 请求 | 吞吐量:第一片 → 最后一片 | 漂移 | GPU 温度 | Bridage |
|---|---|---|---|---|---|
| 1 小时,gpt-oss 120B,16 名用户,14 个切片 | 896 次,零失败 | 124,8 → 124,8(122,6 至 128,1) | 0,0 % | 77 °C / 66 °C | 无 |
| 2 小时,Llama 3.3 70B NVFP4,8 个用户,33 个区间 | 1,056 次,零失败 | 38,70 → 38,46(38,40 至 38,70) | −0,6 % | 72 °C / 58 °C | 无 |
在一小时内,16 个用户持续发送包含 4 096 个 token 的请求,响应为 512 个 token。14 个包含 64 个请求的区间给出的总吞吐量几乎相同,从 122,6 到 128,1 tok/s 不等;第一段和最后一段都达到 124,8 tok/s。每个人看到自己的响应以约 8 tok/s 的速度逐字写出。本次测试中 GPU 时钟的中位数为 2 509 MHz。
在两小时内,8 个用户使用 Llama 3.3 70B 的 NVFP4 格式进行工作;这是一种压缩的 NVIDIA,每个请求读取 1 024 个 token、写入 256 个 token。在 33 个包含 32 个请求的区间内,总吞吐量始终保持在 38,40 至 38,70 tok/s 之间。
第一段与最后一段之间的漂移为 −0,6%;如果比较前五段和后五段的中位数,则为 −0,2%。每个人看到自己的响应以约 5,1 tok/s 的速度写出,第一个词在 2,8 秒后到达(中位数)。GPU 时钟的中位数为 2 528 MHz。
驱动程序在两次测试期间都没有报告任何限速原因:测得的数值逐秒保持为零。GPU 在 16 名用户时最高达到 77 °C,在 8 名用户时最高达到 72 °C。系统传感器中最热区域在第一次测试期间达到 87 °C,在第二次测试期间达到 80 °C。
在第二次测试期间,SSD 的最高温度达到 49 °C。固件没有为这些区域命名,因此我们不将其归为处理器区域。作为对比,StorageReview 测得 Founders Edition、Dell 机器和 GIGABYTE 在负载峰值时的最高温度为 87 至 88 °C。
#空闲状态
安静运行 20 分钟后,我们记录了机器 30 分钟。GPU 平均功耗为 10,4 W(10,2 至 11,0 W),温度保持在 35 至 36 °C 之间。系统传感器中最热的区域最高升至 46 °C,SSD 则保持在 34 至 35 °C 之间。没有报告任何需要降频的原因。
标示的功率是 GPU 的功率,由其传感器报告;它不代表整台机器的总功耗。环境温度没有记录。一小时的测试在傍晚进行,2 小时的测试在夜间进行,当时房间可能更凉。
#SSD:读取速度 13 GB/s,1.28 百万 IOPS
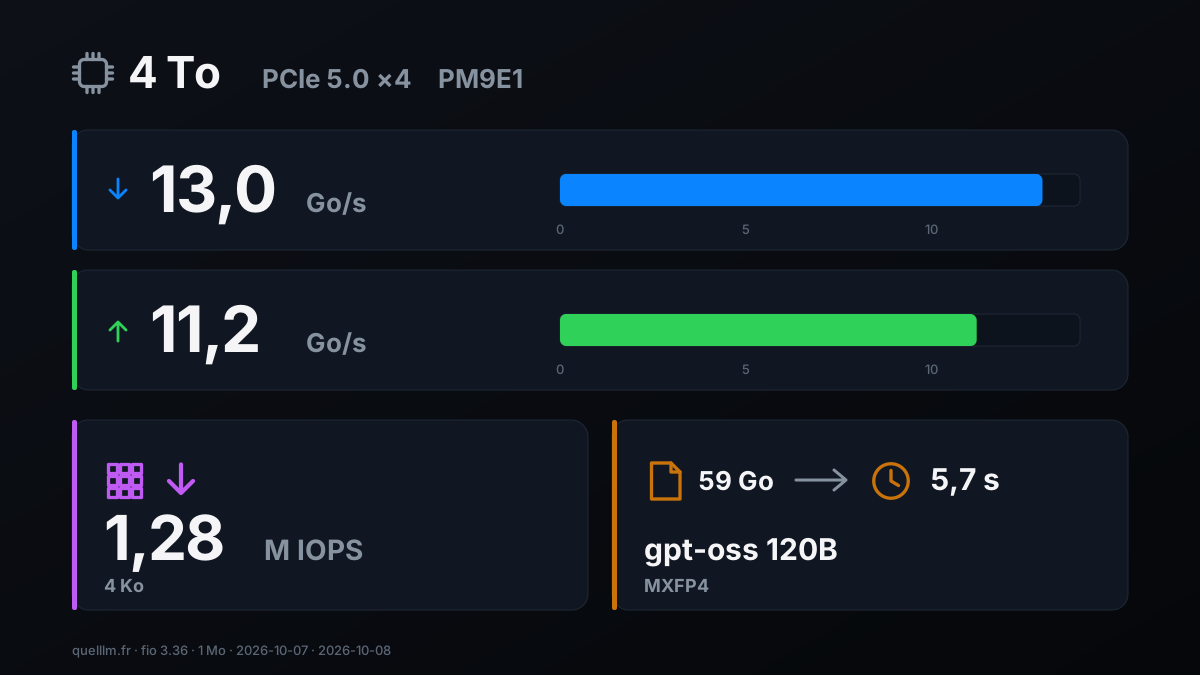
9000 型号搭载 4 TB Samsung MZALC4T0HBL1 SSD,属于 PM9E1 系列。系统确认 PCIe 5.0 链路:4 条通道上的 32 GT/s。PCIe 是 SSD 与芯片之间的连接;5.0 版本的速度是 4.0 版本的两倍。
我们使用 fio 3.36 进行了测量:针对一个已完整写入后再读取的 64 GB 文件,采用直接访问,也就是说不经过系统缓存。IOPS 是每秒读取或写入操作的次数。
| Test | 结果 |
|---|---|
| 顺序读取,块大小为 1 MB,1 个任务 | 13,0 GB/s(使用 io_uring 时为 12,99,使用 libaio 时为 13,37;这是 Linux 的两种磁盘访问方法) |
| 随机读取,4 KB 块,4 个任务 | 使用 io_uring 时为 1.28 百万 IOPS,使用 libaio 时为 1.19 百万 IOPS(使用 io_uring 时约为 4.9 GB/s) |
| 连续突发写入,1 MB 块,新建 32 GB 文件,磁盘处于空闲状态 | 11,2 GB/s |
| 读取 gpt-oss 120B 文件(59 GB) | 5,7 s |
StorageReview 使用另一款工具(gdsio)和相同型号的 SSD,测得读取速度为 11,0 至 11,6 GB/s,写入速度为 12,2 GB/s。我们的数值处于同一数量级,读取速度略高。实际使用中,大型模型可在几秒内加载:59 GB 的 gpt-oss 120B 文件在 5,7 秒内完成读取。
在 9000 上,您会看到 Founders Edition 的 4 TB SSD:它是同一型号,因此无法据此区分 ATOM 与 NVIDIA 参考型号。GIGABYTE 的不同参考型号之间确实存在差异:9000 配备 PCIe 5.0 SSD,而 9001 和 9002 配备 PCIe 4.0 SSD。SSD 测试数据针对的是 9000 型号。
#64 还是 128 GB?
2026 年 10 月 2 日,NVIDIA 宣布推出一款配备 64 GB 内存的 DGX Spark,可运行最多 1000 亿参数的模型,并将于 10 月 23 日起由 Acer、ASUS、Dell、GIGABYTE、HP 和 MSI 提供,起价 4 999 美元。GIGABYTE 于 10 月 5 日确认推出同样设计、配备 64 GB 内存的 AI TOP ATOM。截至目前,在法国的供货情况尚未确认。我们没有对其进行测量。
我们从该系列首篇指南中获得的数据可以进行计算。上下至 Qwen3-Coder 30B-A3B 的型号,在 32 768 个上下文 token 下占用不到 35 GB,并且可以装入 64 GB。Llama 3.3 70B(51 GB)将处于临界状态。gpt-oss 120B(62 GB)以及更大的型号将无法装入。在带宽相同的情况下——这一点仍需验证——速度应该相近。
要在单台机器上运行参数量超过 1000 亿的模型,必须选择 128 GB 版本。GIGABYTE 页面上的六个参考型号可以让你选择内存和 SSD。
#按型号列出的价格(2026 年 10 月 8 日记录)
GB10 的价格每周都会变动:购买前请核实。以下是我们于 2026 年 10 月 8 日在法国记录的含税价格。务必比较相同的型号:9001(PCIe 4.0)和 9000(PCIe 5.0)不是同一台机器。
| Marchand | 参考 | 含税价 | 显示的供货情况 |
|---|---|---|---|
| AORUS 官方商店 | 9001(PCIe 4.0,4 TB) | 6 346,27 € | 缺货 |
| Amazon.fr,由 Amazon UK 销售 | 9001(PCIe 4.0,4 TB) | 价格浮动,请在 Amazon.fr 上查看 | 1 个样本 |
| LDLC | 9000(PCIe 5.0,4 TB) | 7 999,95 € | Rupture |
| Rue du Commerce,第三方卖家 | 9000(PCIe 5.0,4 TB) | 起价 7 999,95 €(3 个报价) | 取决于卖家 |
| Senetic.fr | 9000(PCIe 5.0,4 TB) | 9 022,08 € | 5 台 |
Materiel.net 为 9000 型号标出的价格与 LDLC 相同,同样缺货。作为比较,同一天,另一款 GB10 机器 MSI EdgeXpert 在 Materiel.net 标价 6 599,95 €,也处于缺货状态;PNY 的 DGX Spark 已不再在该网站或 LDLC 上销售。缺货机器的标价不是购买价格:也请查看供货情况。
#我们没有测量的内容
- 与 DGX Spark 的比较
- 比较基于已公布的 DGX Spark 测量数据,并使用所标明的软件版本在 ATOM 上重新测试。
- 噪音
- 本页引用的噪声评价来自 Peter Falkingham 的测试。
- 整机功耗
- 本页面的功耗数据仅对应 GPU。该系列的下一篇指南将详细介绍功耗。
- 室温
- 公布的温度来自机器内置的传感器。
- 两台机器之间的连接
- 两个 QSFP 端口(200 Gb/s)未进行测试。
- 其他型号与 64 GB 版本
- 测量针对的是 128 GB 的 ATAGB10-9000 参考型号。
如果新版 DGX OS、固件或我们的工具改变这些结果,本页面将会更新;每项更正都会标注日期。
#AI TOP ATOM 适合哪些人
以下内容来自我们对 9000 参考型号的测量,以及我们在 2026 年 10 月 8 日进行的价格记录。
- 你想要 GB10 的基准性能,同时拥有精致的机箱
- 9000 的速度与已发布的 DGX Spark 数值最多相差 4,3%,其 PCIe 5.0 接口上的 4 TB SSD 测得读取速度为 13 GB/s。
- ……你把机器放在桌面上
- 它可以放进一升的空间,重 1,2 kg,正面设计简洁。空闲时,GPU 功耗约为 10 W。
- ……您要服务一个团队或 AI 代理
- 在 gpt-oss 120B 上以 16 名用户运行一小时,然后在 Llama 3.3 70B 上以 8 名用户运行两小时:速度保持稳定(漂移分别为 0,0 % 和 −0,6 %),没有任何限速。
- ……您想在不更换芯片的情况下少花钱
- 9001 配备 4 TB PCIe 4.0 SSD,2026 年 10 月 8 日在 AORUS 官方商店标价 6 346,27 €,当时缺货;在 Amazon.fr 有库存。它使用相同的芯片和相同的 128 GB;本页记录针对的是 9000 型号。
- ……你的模型及其上下文占用不到 35 GB
- 64 GB 版本计划于 2026 年 10 月 23 日发布,应该够用(计算依据来自我们的第一篇指南,未在该版本上实测)。请等待其上市和定价。
- ……你想连接多台机器
- 两个 QSFP 接口(200 Gb/s)就是为此用途准备的。GIGABYTE 单独销售线缆。
#FAQ
AI TOP ATOM 和 NVIDIA 的 DGX Spark 一样快吗?+
ATOM 与 Founders Edition 之间具体有哪些变化?+
AI TOP ATOM 长时间工作时会降速吗?+
该选哪个型号:9000、9001 还是 9002?+
是否应该等待 64 GB 版本?+
有反馈、发现了错误,或想补充说明?请告诉我们,让这份指南对每个人都更有帮助。