在 GB10 上本地运行 70B LLM:教程 complet
在 GIGABYTE AI TOP ATOM(NVIDIA GB10 芯片,128 GB)上,Llama 3.3 70B 运行起来绰绰有余:8,192 token 上下文时占用 43.6 GB,131,072 时占用 82 GB。通过三种方式——Ollama、llama.cpp 或 vLLM——其生成速度为每秒 4.6 到 5.3 个 token。搭配 Llama 3.2 1B 草稿模型后,llama.cpp 在散文上达到每秒 12 个 token,在代码上达到 19 个。在八个用户并发时,vLLM 在两小时内平均保持每秒合计 38.6 个 token。
像 Llama 3.3 70B 这样拥有 700 亿参数的模型属于“稠密”模型:生成每个词都要用到全部参数,因此需要大量内存。GB10 机器的 128 GB 内存可轻松容纳它。本教程给出三种安装方式的命令,均在 GIGABYTE 免费提供的 AI TOP ATOM 上测试,随后给出有助于选择的测量结果:速度、小型草稿模型、上下文内存、两小时持续运行表现以及多用户服务。
#机器、方法与单位
先介绍几个术语。token 是单词的片段:在法语中,一个 token 约相当于三分之二个单词。上下文是模型在一次交流中保留在内存中的文本:包括您的问题、您的文档以及它的回答。生成速度是回答显示的速率,单位为每秒 token 数(tok/s)。读取速度是机器在回答之前处理您输入文本的速率。
该机器为 GIGABYTE AI TOP ATOM,型号 ATAGB10-9000。其 NVIDIA GB10 芯片集成了 20 个 Arm 核心和一颗 Blackwell GPU,二者共享 128 GB、273 GB/s 的内存。SSD 为 4 TB PCIe 5.0。系统为 DGX OS 7.5.0,即 NVIDIA 基于 Ubuntu 的系统(驱动 580.159.03,CUDA 13.0)。系统可识别 121.7 GB 内存。
- 源自 NVIDIA GB10 平台的部分
- 这块芯片、其 128 GB 内存与 273 GB/s 带宽以及 DGX OS 决定了本指南中的速度。我们复现了针对 NVIDIA DGX Spark 发布的两项参考测试(分别使用 llama.cpp 和 Ollama),我们的速度与之相差最多 4.3%。据我们所知,这些速度因此应同样适用于其他 128 GB 的 GB10 机器。本指南的测量数据均基于 AI TOP ATOM。
- 来自 GIGABYTE 的部分
- 约一升的机箱及其散热、做工、型号(9000 配备 4 TB PCIe 5.0 SSD)以及经销商保修。在我们两小时的连续服务期间,GPU 温度未超过 72 °C,也未出现降频。
测量于 2026 年 10 月 6 日和 7 日进行(使用 Open WebUI 的私有助手测量于 10 月 7 日和 8 日进行)。测试方案于 10 月 6 日 13:30 锁定,早于第一次测量。随后通过注明日期的补充条款加入了推测解码和内存预算,这些条款均在其所描述的测试之前撰写。我们表格所用的方法和数据已在方法页面公布。
llama.cpp 和 TensorRT-LLM 的生成速度来自六段 400 token 的文本:三段法语散文和三个代码请求。Ollama(一段 300 词的文本)和 vLLM(输入 1,024 token、输出 256 token 的随机请求)的速度遵循各自章节所述的方案。温度设为 0:模型始终选择概率最高的词,使测试具有可比性。我们公布每种类型三段文本的中位数。
内存容量以 GB 为单位(1 GB = 1 024 MB,与 Linux 的显示一致);GB/s 带宽为厂商公布的数值,采用十进制单位。所用版本为 llama.cpp b11430(2026 年 10 月 5 日构建)、Ollama 0.34.1、vLLM 26.09 和 TensorRT-LLM 1.3.0rc12,后两者运行在 NVIDIA 的容器中。本系列的第一篇指南给出了 13 个模型的测量结果,其中包括 Llama 3.3 70B;本篇介绍如何安装并加速它。
#途径 1:Ollama,最简单
Ollama 是最简单的入门方式:解压一个压缩包,用一条命令下载模型,再用另一条命令与它对话。我们使用面向 Linux Arm 的官方压缩包安装了 0.34.1 版本,放在一个文件夹中,未注册系统服务。如果您更喜欢常规安装程序,可参阅我们的 Linux 安装指南。
--verbose 选项会在回答结束时显示统计信息。在我们的测试中,Llama 3.3 70B(Q4_K_M,一种权重压缩格式)第一次运行的写入速度为 4.97 tok/s,第二次为 4.95 tok/s。ollama ps 命令显示加载了 85 GB(十进制单位):Ollama 自行开启了 131,072 个 token 的上下文。对于 18,823 个 token 的文本,读取耗时 55.6 s,即 338.7 tok/s,随后的写入速度保持在 4.38 tok/s。
为便于理解这些数字:Ollama 公布了 Llama 3.1 70B Q4_K_M 在 NVIDIA 的 DGX Spark 上的速度为 4.423 tok/s(版本 0.12.6,2025 年 10 月 23 日)。使用相同版本、相同脚本和相同模型(Llama 3.1 70B),我们的 ATOM 得到 4.34 tok/s,相差在 2% 以内。如需缩小上下文并减少内存占用,请在启动服务器前设置 OLLAMA_CONTEXT_LENGTH 变量;我们未测量这种配置。
#方案 2:llama.cpp,可调设置最多的方案
llama.cpp 是一款应用非常广泛的开源引擎。它读取 GGUF 格式的模型,即包含权重的单个文件。它需要针对 GB10 芯片编译一次,但能开放所有设置:上下文大小、上下文缓存格式、草稿模型。编译沿用 NVIDIA 的指南,采用 GB10 对应的 CUDA 架构 121a-real,但不启用 libcurl(-DLLAMA_CURL=OFF),也不启用 RPC。
所选文件是 bartowski 发布的 Llama 3.3 70B Q4_K_M 版本:39.6 GB。在清空磁盘缓存的情况下,llama.cpp 从 SSD 加载它需要 8 秒。hf 命令来自 huggingface_hub 库(安装:pip install -U huggingface_hub)。如果 Hugging Face 要求接受 Llama 许可证,请在网站上接受,然后使用 hf auth login 登录。
- -ngl 99
- 将模型的所有层都放到 GPU 上。
- -fa on
- 启用 Flash Attention,使上下文读取更省资源。
- -lm dio
- 通过直接磁盘访问读取文件,不经过系统缓存(mmap)。这是 llama.cpp 项目为 DGX Spark 发布的参考表格所采用的模式。
- -c 16384 -np 1
- 单个用户可用 16,384 个 token 的上下文。所请求的上下文由同时在线的用户共享。
- --host 127.0.0.1
- 该服务器只能从本机访问。
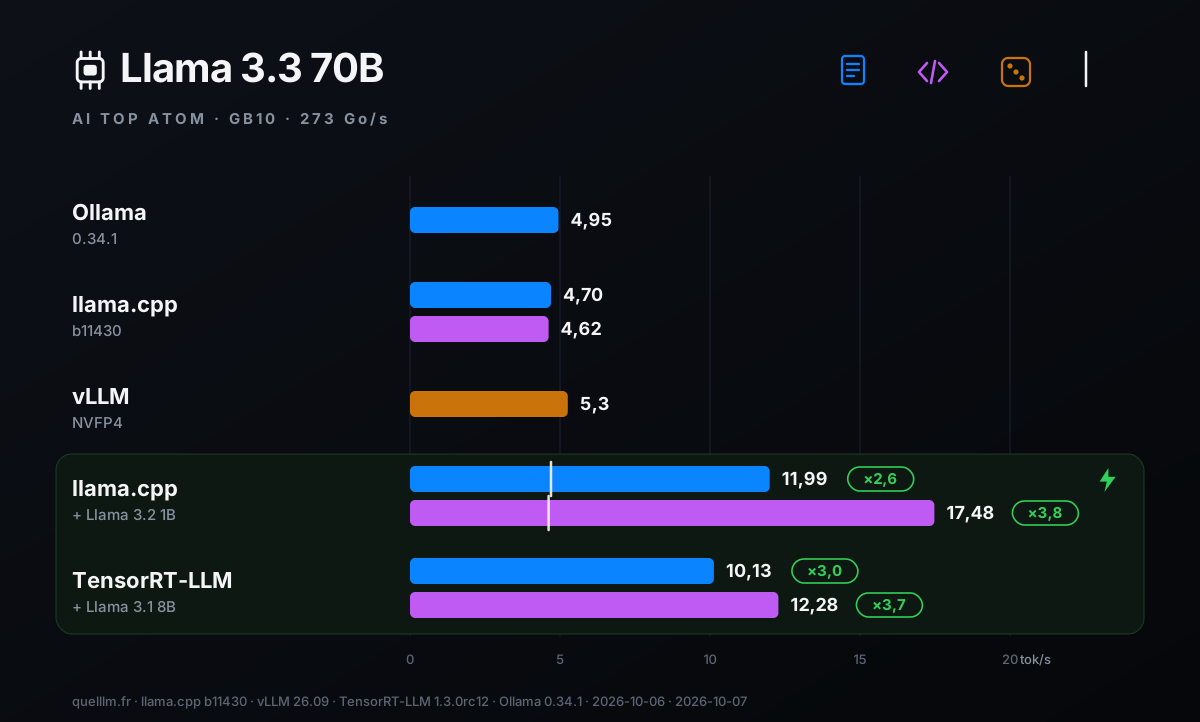
在我们的六段文本上,llama-server 的生成速度为散文 4.70 tok/s、代码 4.62 tok/s。测量工具 llama-bench 给出的生成速度为 4.8 tok/s(32 个 token),读取速度为 405 tok/s(2 048 个 token)。在 8 192 个 token 的上下文下,该模型占用 43.6 GB。
作为参考,内存每秒最多读取 2730 亿字节,而每个 token 都需要重新读取一遍模型权重,即 425 亿字节:理论最大值为 6.4 tok/s,实测值约达到其四分之三。
#途径 3:NVFP4 格式的 vLLM,适合多用户
vLLM est un serveur conçu pour répondre à plusieurs personnes en même temps. NVIDIA le fournit dans un conteneur, c'est-à-dire un programme isolé que lance Docker. Le modèle est Llama 3.3 70B en NVFP4, un format 4 bits de NVIDIA que les puces Blackwell calculent directement : il occupe 39,9 GB en mémoire. La matrice des modèles pris en charge dans le guide vLLM de NVIDIA pour DGX Spark liste ce modèle.
--max-model-len 8192 和 --max-num-seqs 16 这两项设置将上下文限制为 8192 个 token,并将同时处理的请求限制为 16 个。--gpu-memory-utilization 0.85 设置决定 vLLM 预留的内存比例:此处为 103 GB,其中 59.6 GB 用于缓存。该缓存可同时容纳 390,352 个 token,相当于同时处理近 48 个 8192 token 的请求。首次启动约需 7 分钟:读取模型 4 分 20 秒,随后约 2 分钟准备。
单个用户时,vLLM 的生成速度为 5.3 tok/s(三轮分别为 5.26、5.27 和 5.26),首个词平均在 0.73 秒内到达。八名用户同时使用时,机器总输出为 37.7 tok/s(含等待首个词的时间);回复开始后,每名用户获得 5.0 tok/s。
首个词平均在 2.8 秒内到达,最慢的情况下也不超过 4.8 秒。本测试的请求输入 1024 个 token、输出 256 个 token;每个数据点测量三次。
#三种方案并列对比
| 路径 | 生成 | 内存 | 设置 | 选择它用于 |
|---|---|---|---|---|
| Ollama 0.34.1(Q4_K_M) | 4,95 | Ollama 显示占用 85 GB(十进制单位,按本指南的口径约为 79 GB),此时使用其默认开启的 131,072 token 上下文 | peu | 快速上手 |
| llama.cpp b11430(Q4_K_M) | 普通文本 4.70,代码 4.62 | 8192 个 token 时为 43.6 GB,32768 个时为 51.3 GB | 全部:上下文、缓存、草稿模型 | 一个用户,使用草稿模型 |
| vLLM 26.09(NVFP4) | 5.3;8 个用户合计 37.7 | 设置为 0.85 时预留 103 GB | 服务器的那些 | 多个用户 |
三种途径的生成速度相同,差异在 15% 以内。原因很简单:每生成一个 token,芯片都要重新读取一遍模型权重,而密集模型的节奏由 273 GB/s 的带宽决定。因此,一个 70B 模型的生成速度约为 5 tok/s,即每分钟约 200 个单词,相当于从容阅读的速度。
这一速度适合不急于求成的处理任务:摘要、信息提取、审校、回复草稿。对于流畅的对话,有两种手段,将在后续章节介绍:草稿模型,以及每个 token 只使用部分参数的 MoE(mixture of experts,混合专家)模型。
#用小型草稿模型加速 70B 模型
推测解码使用一个小模型(即草稿模型)提前提议若干个词(更准确地说是 token;为简便起见我们称之为“词”)。大模型一次前向传递即可验证这些词:耗时大约相当于只写一个词,因为时间主要花在读取权重上。
正确的词被保留,其余的被丢弃。草稿模型并不决定文本:始终由大模型进行验证。NVIDIA 在其 DGX Spark 指南中描述了这一原理,LMSYS 博客也指出,该技术能在一定程度上缓解这台机器的带宽限制。
#使用 llama.cpp:Llama 3.2 1B 草稿模型
草稿模型必须与大模型“说同一种语言”,即使用相同的分词方式。Llama 系列符合要求:Q8_0 格式的 Llama 3.2 1B 可搭配 Llama 3.3 70B 使用。四个选项就足够了:-md 指定草稿模型,--spec-type draft-simple 选择方法,--spec-draft-n-max 设定提前提出的 token 数量(本指南中称之为“词”),-ngld 99 将草稿模型放到 GPU 上。
| 配置 | 法语散文 | 代码 | 接受率(散文 / 代码) |
|---|---|---|---|
| 仅 70B | 4,70 | 4,62 | — |
| + Llama 3.2 1B 草稿模型,提前 8 个词 | 11,99 (×2,6) | 17,48 (×3,8) | 33 % / 50 % |
| + 草稿模型 Llama 3.2 1B,提前 16 个词 | 10,84 (×2,3) | 18,65 (×4,0) | 19 % / 34 % |
这个 10 亿参数的草稿模型让 70B 模型提速 2.6 到 4 倍:散文 12 tok/s,代码最高 19 tok/s。增益取决于文本。在三段代码文本上,提前提出 8 个词时速度为 13.2 到 18.0 tok/s。草稿模型的建议在代码上(保留 50% 的词)比在散文上(33%)更常被采纳。
我们的散文文本为法语,代码文本为英语;换用其他文本会得到不同的增益。对于散文,提前 8 个词的效果优于 16 个(11.99 对 10.84)。对于代码,16 个略好一些(18.65 对 17.48),但不同文本之间的差异也在同一量级。建议从 8 开始。
当模型自带多 token 预测(MTP)模块时,无需第二个文件也能使用同样的原理。使用 Qwen3.8 27B 和 --spec-type draft-mtp 选项,llama.cpp 在散文上从 11.71 提升到 21.48 tok/s(×1.8),在代码上从 11.59 提升到 27.23 tok/s(×2.3)。
#使用 TensorRT-LLM:NVIDIA 的 Draft-Target 方案
TensorRT-LLM 是 NVIDIA 用于优化模型服务的库。其 DGX Spark 指南提供 Draft-Target 方法:FP4 格式的 Llama 3.3 70B 搭配 FP4 格式的 Llama 3.1 8B 作为草稿模型。两个模型均由 NVIDIA 提供。在容器 1.3.0rc12 版本中,该设置的值写作 Draft_Target,使用下划线。
| 配置 | 法语散文 | 代码 |
|---|---|---|
| + Llama 3.1 8B FP4 草稿模型,提前 4 个词 | 10.13(相比同一引擎不使用草稿模型提升 3.0 倍) | 12,28 (×3,7) |
使用 TensorRT-LLM 时,与不使用草稿模型的同一引擎相比,草稿模型使散文生成速度提升 3.0 倍,代码提升 3.7 倍:此时 70B 在散文上每秒生成 10.1 个 token,在代码上为 12.3 个。
因此,llama.cpp 和 TensorRT-LLM 两种方案带来的提升处于同一量级,为 2.6 至 4 倍。对于单个用户,llama.cpp 仍是最简单的:一个草稿模型文件加四个选项。如果您想采用 NVIDIA 的官方方案,并使用 NVIDIA 提供的 FP4 模型,则应选择 TensorRT-LLM。
#上下文的内存预算,从 8,192 到 131,072 个 token
上下文是有内存成本的:KV 缓存。这是模型用来保存已读取内容、避免重复计算的内存。它会随上下文长度增长。llama.cpp 在加载时就预留全部缓存,因此加载完成后占用的内存就已经是最终内存。
我们在清空磁盘缓存后,通过可用内存(Linux 的 MemAvailable)的下降量来测量它。选项 -ctk q8_0 -ctv q8_0 将缓存以 8 位而非 16 位(f16)存储,从而减小其占用。在表格和图表中,8k 表示 8 192 个 token 的上下文,32k 表示 32 768,64k 表示 65 536,128k 表示 131 072。
| 模型 | Cache | 8 192 | 32 768 | 65 536 | 131 072 |
|---|---|---|---|---|---|
| Llama 3.3 70B Q4_K_M | f16 | 43,6 | 51,3 | 61,4 | 81,9 |
| Llama 3.3 70B Q4_K_M | q8_0 | 42,3 | 46,4 | 52,2 | 63,1 |
| gpt-oss 120B MXFP4 | f16 | 61,0 | 61,9 | 63,0 | 65,6 |
| gpt-oss 120B MXFP4 | q8_0 | 60,7 | 61,3 | 62,1 | 63,2 |
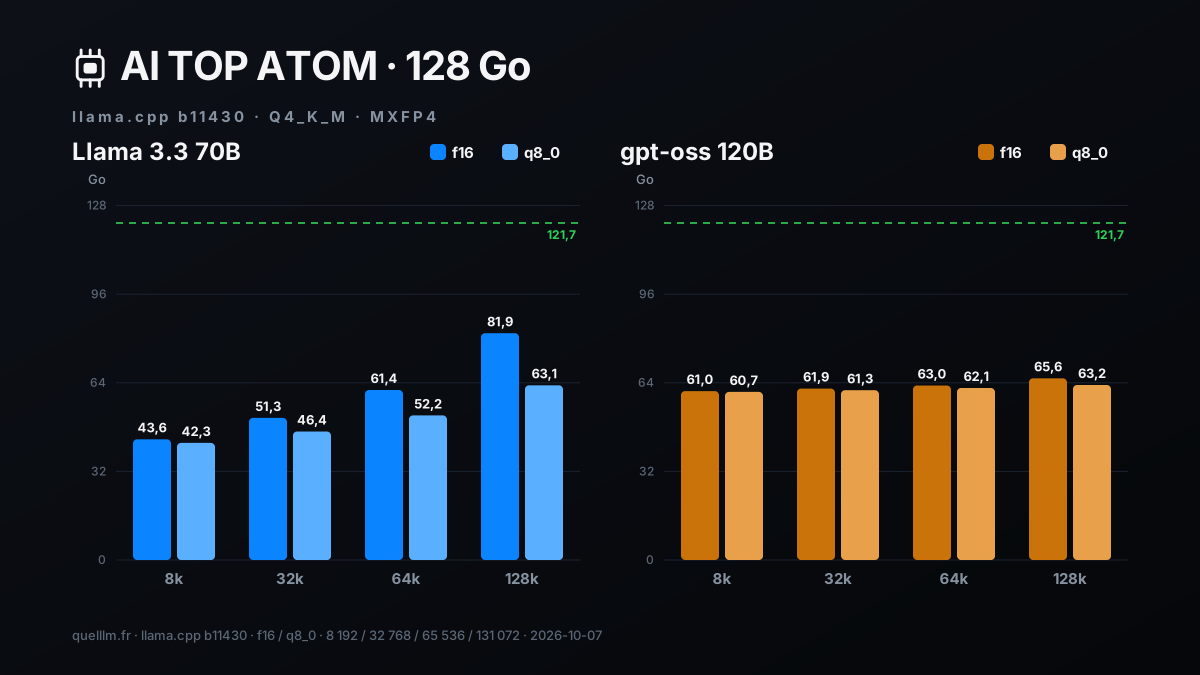
全部都能装进 121.7 GB,即使是 70B 在 f16 下使用 131,072 个 token 的上下文:81.9 GB。在 f16 下,从 8k 到 128k,上下文为 70B 增加 38 GB;在 q8_0 下增加 21 GB,几乎少了一半。gpt-oss 120B 仅增加 4.6 GB:它交替使用关注全文的层和只关注短窗口的层。q8_0 格式的代价是速度略低,70B 在 128k 时慢 9% 至 11%(见下表)。
我们还用 Service-Public 的实用指南将上下文填充至 90%,以测量满上下文时的读取和生成速度。在 128k 时,文本对 70B 模型为 117 605 个 token,对 gpt-oss 120B 为 117 889 个 token,约合 200 页。
| 模型 | Cache | 读取文本(token) | 内存(GB) | Lecture | 生成 |
|---|---|---|---|---|---|
| Llama 3.3 70B | f16 | 29 214 (32k) | 51,4 | 286,1 (102 s) | 4,22 |
| Llama 3.3 70B | q8_0 | 29 214 (32k) | 46,5 | 271,1 (108 s) | 4,02 |
| Llama 3.3 70B | f16 | 117 605 (128k) | 82,0 | 181,9 (646 s) | 2,86 |
| Llama 3.3 70B | q8_0 | 117 605 (128k) | 63,2 | 164,6 (715 s) | 2,54 |
| gpt-oss 120B | f16 | 29 227 (32k) | 61,7 | 1 443 (20 s) | 43,81 |
| gpt-oss 120B | q8_0 | 29 227 (32k) | 61,2 | 1 401 (21 s) | 43,96 |
| gpt-oss 120B | f16 | 117 889 (128k) | 65,4 | 1 073 (110 s) | 26,93 |
| gpt-oss 120B | q8_0 | 117 889 (128k) | 63,4 | 993 (119 s) | 24,97 |
在满上下文下一切正常运行。gpt-oss 120B 在 110 秒内读完一篇 200 页的文本,并以接近 27 tok/s 的速度继续生成。70B 模型以 182 tok/s 的速度读取全部 117,605 个 token。对于超长文档,MoE 模型无论读取还是生成都更快。
#面向八个用户连续服务两小时
服务器必须能够长时间稳定运行。我们启动了 vLLM 26.09,加载 NVFP4 格式的 Llama 3.3 70B,并持续发送请求两小时:八名用户持续使用,每批 32 个请求,输入 1024 个 token、输出 256 个 token。芯片监测以每秒一次的频率记录了 GPU 的功耗、频率和温度。
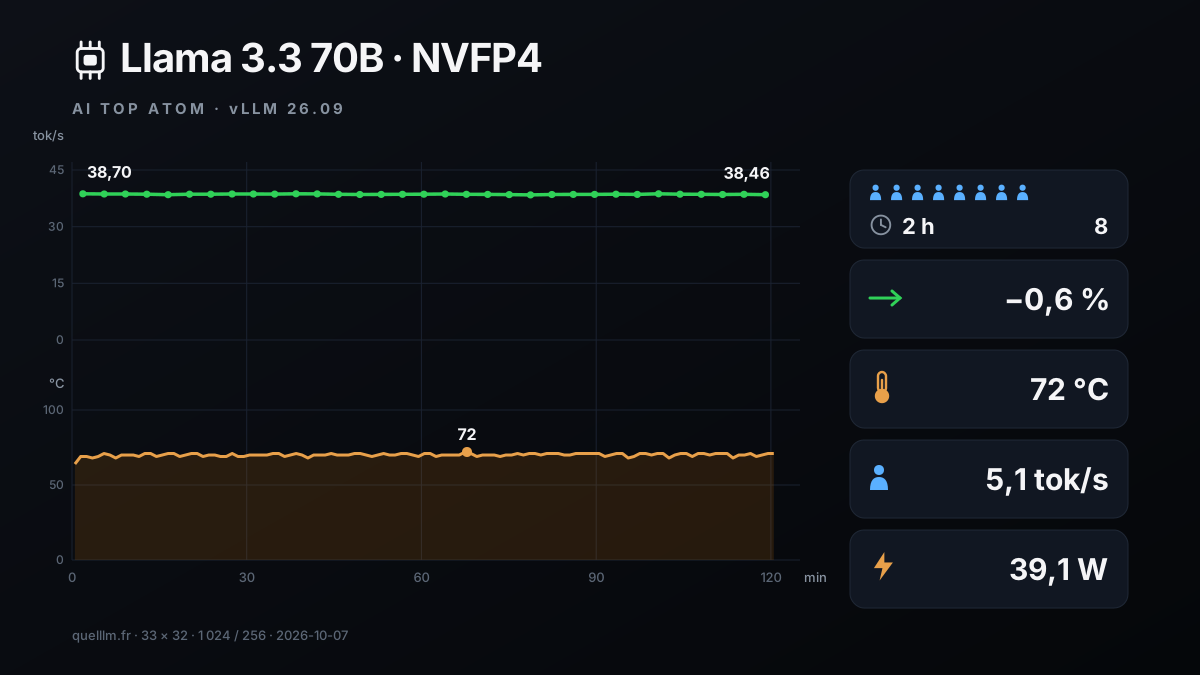
结果很简单:速度没有变化。总吞吐量从第一批的 38.70 tok/s 到最后一批的 38.46,最低 38.40,最高 38.70:差异为 −0.6%。每位用户获得 5.1 tok/s。首个词出现时间的中位数为 2.8 秒,各批次在 2.4 至 2.9 秒之间。
总计,该机器处理了 1,056 个请求,读取 1,081,344 个 token,生成 270,336 个 token,没有任何错误。GPU 温度最高为 72 °C。其频率中位数为 2,528 MHz,在两小时的记录期间未发现任何降频原因。
GPU 平均功耗为 39.1 W,峰值为 95.0 W。这些功耗数值仅指 GPU,由芯片自身读取:不包括处理器、内存、SSD 和电源。两小时内 GPU 耗电 78.8 Wh,按 EDF Tarif Bleu Base(6 kVA)每 kWh 20.01 欧分的电价计算,约合 1.6 欧分。
#将其用作服务器:OpenAI API、密钥与 Open WebUI
OpenAI API 是一种许多工具都能使用的请求格式:代码编辑器、聊天界面、脚本等。llama-server 和 vLLM 都提供这种 API。为了保护它,llama-server 可通过 --api-key 选项设置密钥:未提供密钥时,它会返回 401 错误。我们已使用 gpt-oss 20B 验证了这三个调用;对于 70B 模型,命令相同,只是换一个文件。
第一次调用返回 401,第二次返回所服务的模型列表,第三次返回 OpenAI 格式的响应。--jinja 选项会应用模型文件中提供的对话模板。
如需聊天界面,可将 Open WebUI 接入此 API。以下是我们私有助手测试(本系列的另一篇指南)所用的技术栈,搭配 gpt-oss 120B。模型服务器位于内部 Docker 网络中,无法访问互联网。Open WebUI 0.11.4 同时连接到该网络和一个访问网络。
这样,模型就没有任何对外出口。服务器不设密钥,因为只有内部网络能够访问它;OPENAI_API_KEY 的值 local 仅用于满足 Open WebUI 的要求。若要改为提供 70B,请将文件路径替换为 Llama-3.3-70B-Instruct-Q4_K_M.gguf 的路径,并根据上文的内存预算调整 -c 和 -np。
然后在本机的浏览器中打开 http://127.0.0.1:3100:模型会出现在列表中。在我们的私人助手测试中,包括额外一个嵌入服务器(bge-m3)在内的完整技术栈在 66 秒内准备就绪。根据 NVIDIA 的 llama.cpp 指南,Open WebUI、Continue.dev 及其他客户端均可接入此 API,它遵循 OpenAI API 格式(服务器地址后接 /v1)。
#更快的替代方案:一个 120B 的 MoE 模型
MoE(mixture of experts,混合专家)模型包含大量参数,但每个 token 只使用其中一小部分。gpt-oss 120B 共有 1170 亿参数,其中 51 亿为激活参数,OpenAI 直接以 MXFP4 格式发布该模型。
在 GB10 上,使用测量工具 llama-bench(生成 32 个 token)时其生成速度为 58.0 tok/s,在 llama-server 上进行长回复时为 54.4 tok/s,散文和代码皆然。这是稠密 70B 模型速度的 11 倍以上,内存占用在 8 192 个 token 时为 61.0 GB,在 131 072 个 token 时为 65.6 GB。
速度并不说明质量:我们没有比较这两个模型的回答。选择方法如下。对话、智能体和长文档等速度很重要的场景,请选择 gpt-oss 120B。如果您需要的正是这个模型(例如基于它微调的模型),或者用于 5 tok/s 就已足够的批处理任务,请选择 Llama 3.3 70B。13 个模型(从 4B 到 235B)的测量结果见本系列的第一篇指南。
#本指南未测量的内容
- 回答质量
- 我们测量的是速度和内存,而不是每个模型的能力高低。
- 草稿模型在其他文本上的提速效果
- 我们的六份文本中,散文部分为法语,代码部分为英语。提升幅度取决于文本和语言。
- 超过 131,072 个 token 的上下文
- 我们既未测量它们的内存占用,也未测量其速度。
- 其他 GB10 机器和 64 GB 版本
- 我们在 ATOM 128 GB 上的测量结果与已发布的 DGX Spark 参考数据一致。
- 整机功耗
- 所给功耗(瓦)为 GPU 功耗,由芯片读取。
更新与更正:如果 DGX OS、llama.cpp、Ollama、vLLM 或 TensorRT-LLM 的新版本改变了这些结果,本页面将进行修订;每次更正都会注明日期。
#谁适合选择 ATOM
以下内容来自我们在 ATOM(一台 128 GB 的 GB10 机器)上的测量。
- 如果您想在自己家里运行 700 亿参数的模型,ATOM 是正确选择
- 它能宽裕地容纳:在 121.7 GB 中占用 43.6 至 82 GB,上下文为 8,192 至 131,072 个 token,且三种安装途径均可正常工作。
- ……如果多人或多个智能体共享该模型
- 八位用户在短测试序列中合计达到 37.7 tok/s,在两小时内平均为 38.6 tok/s,且没有任何错误。
- ……如果您想在不更换机器的情况下提速
- 一个小型草稿模型可将 70B 模型的速度提升至 2.6 到 4 倍,无论使用 llama.cpp 还是 NVIDIA 的方案。
- ……如果您需要快速对话或处理长文档
- gpt-oss 120B 的生成速度为 54.4 tok/s,读取 200 页需 110 秒。
- ……如果您的工作依赖 NVIDIA 生态系统
- 在我们的测试中,CUDA 13、NVIDIA 容器中的 vLLM 和 TensorRT-LLM,以及为 GB10 编译的 llama.cpp,均可在 DGX OS 7.5.0 上正常运行。
GIGABYTE 方面,这台约一升的机箱在连续两小时满载期间将 GPU 温度控制在最高 72 °C,没有出现降频。GB10 机器的价格每周都在变动:购买前请在机器的产品页上核实。
#FAQ
能否在 128 GB 的 GB10 机器上运行 70B 模型?+
70B 在 AI TOP ATOM 上的生成速度有多快?+
应该选择 Ollama、llama.cpp 还是 vLLM?+
如何在不更换机器的情况下让 70B 更快?+
70B 能否连续数小时为多人提供服务?+
120B 的 MoE 模型是否优于 70B 稠密模型?+
有反馈、发现了错误,或想补充说明?请告诉我们,让这份指南对每个人都更有帮助。