在 GB10 上进行本地微调:实测数据与 方法
在 GIGABYTE AI TOP ATOM(NVIDIA GB10 芯片,128 GB)上,针对特定任务训练的小模型可以在该任务上超过超大模型。经过 85 分钟的 LoRA 训练,Qwen3-8B 能够零错误提取 200 张从未见过的虚构发票中 95% 的数据,而 gpt-oss 120B 为 62.5%,未经训练时为 26%。使用 Unsloth 的 QLoRA 同样可以运行:70B 需要 41 GB,gpt-oss 120B 需要 64 GB。这次训练的 GPU 侧电费为 1.5 欧分。
微调是在现有模型的基础上再做一些训练,使其能胜任某项特定任务。凭借 128 GB 统一内存,一台 GB10 机器就能在您自己的环境中完成微调,无需租用服务器,也无需把数据交给在线服务。本指南跟随一个完整案例,测量平台是 GIGABYTE 免费提供的 AI TOP ATOM:将发票数据提取为 JSON。指南还给出了使用 Unsloth 运行 QLoRA(同样的方法,用于压缩到 4 位的模型)直至 gpt-oss 120B 的测量结果,以及我们试验所用的命令。
#真实案例:读取发票并生成 JSON
这项任务在小型企业中很常见:根据发票、报价单或贷项通知单的文本,模型需要返回一个 JSON,也就是一份软件可以读取的结构化记录。这份记录包含 31 个计分字段:文档类型、编号、日期、开具方、客户、产品明细行、折扣、总额、增值税、预付款、IBAN。我们选择这项任务,是因为答案可以逐字段核验,无需由另一个模型来评判。
这些文档均为虚构。一个小程序生成了 12 种版式,也就是 12 种发票样式,并使用虚构的公司名称。它的随机性由固定的“种子”控制:每次运行都会生成相同的文档。训练使用 10 种版式上的 2000 份文档。
评估使用 200 份从未见过的文档:100 份采用相同的 10 种版式,另外 100 份采用训练中未出现过的 2 种版式。后面这 100 份能说明模型是真正理解了任务,还是只记住了形式。
模型接收的是文档的文本,而不是图像或 PDF。以下是训练后的模型针对第一份测试文档给出的回答节选,该文档是一张四行的虚构贷项通知单。
#方法:LoRA,一个 epoch,85 分钟
借助我们的经验和引导式路径,打造你的本地助手,在日常中使用你的 AI。
- 在线空间,终身可用
- PDF + 文件
- 30 天内退款
这台机器是 GIGABYTE AI TOP ATOM,型号 ATAGB10-9000:搭载 NVIDIA GB10 芯片、128 GB 统一内存和 4 TB PCIe 5.0 SSD,运行 DGX OS 7.5.0(驱动 580.159.03,CUDA 13.0)。软件方面:NVIDIA 的 PyTorch 容器(版本 26.03,含 PyTorch 2.11)、用于 LoRA 的 PEFT 0.21.2、用于 QLoRA 的 Unsloth 2026.10.1,以及用于模型服务的 NVIDIA vLLM 26.09 容器(vLLM 0.29.0)。本系列的第一篇指南详细介绍了这台机器以及 13 个模型的速度。
LoRA(Low-Rank Adaptation)保持原模型不变,只训练附加到其各层的小型矩阵。训练结果是一个适配器,即与模型一起加载的小文件。这里训练的参数为 4360 万个,而 Qwen3-8B 的参数量为 80 亿。
本指南中有三个术语会反复出现。一个训练步处理一批 4 份文档。一个 epoch 是对全部 2000 份文档完整过一遍。损失衡量模型写出的回答与预期回答之间的差距:越低越好。
- 模型
- Qwen3-8B,采用 bf16(一种 16 位数字格式),未经压缩。
- LoRA
- 秩(rank)16,alpha 32(一个缩放系数),dropout 0.05(每一步随机忽略一小部分值,以抑制过拟合),作用于每层的 7 个投影,即该层的 7 个权重矩阵:q、k、v、o、gate、up、down。秩决定了所添加矩阵的大小。
- 时长
- 1 个 epoch:500 步,每步 4 份文档。
- 学习率
- 1e-4,即 0.0001,先在 30 步内逐步升高,然后按余弦衰减。
- Lots
- 我们按长度对 2000 份文档排序并组成批次,然后使用固定种子打乱批次顺序。同一批次中的文档长度相近,无效填充更少,因此训练速度更快。
- Perte
- 仅针对 JSON 回答计算。提示词和文档均被掩码:模型学习的是写出回答,而不是照抄文档。
- 长度
- 最多 2304 个 token。最长的文档有 2204 个,平均为 1143 个:没有任何文档被截断。
- 内存
- 梯度检查点(gradient checkpointing)已启用:模型会重新计算部分结果,而不是将其全部保留在内存中。
这些设置由我们协议的一份修订确定,日期为 2026 年 10 月 7 日,早于对 200 份测试文档的任何评估。协议在首次测量前已冻结;方法、注明日期的修订清单以及我们表格中的数据都发布在方法页面上。本指南中的内存容量以 GB 为单位,与 Linux 的显示方式一致:1 GB = 1024 MB。
所有操作都在 NVIDIA 的 PyTorch 容器(版本 26.03)中进行。在其中的 Python 环境里安装 transformers 和 PEFT 库。下面的路径已经过简化;选项则是我们测试时实际使用的选项。
#结果:95% 的文档完全正确
评分方法是在规范化之后,逐字段比较模型写出的值与预期值。当一份文档的所有字段都准确时,即为“完美”文档。三个模型接收相同的指令,温度设为 0(使回答最稳定的设置),通过 vLLM 26.09 运行,每次并发处理 16 份文档。Qwen3-8B 关闭了思考功能。gpt-oss 120B 的推理强度设为“低”。
| 模型 | 准确字段 | 完全正确的文档 | 完全正确,已知版式 | 完全正确,新版式 | 处理 200 份文档的耗时 |
|---|---|---|---|---|---|
| 未经训练的 Qwen3-8B | 84,8 % | 26,0 % | 27 % | 25 % | 686 s |
| 未经训练的 gpt-oss 120B | 97,5 % | 62,5 % | 58 % | 67 % | 991 s |
| Qwen3-8B + LoRA(85 分钟) | 99,2 % | 95,0 % | 96 % | 94 % | 524 s |
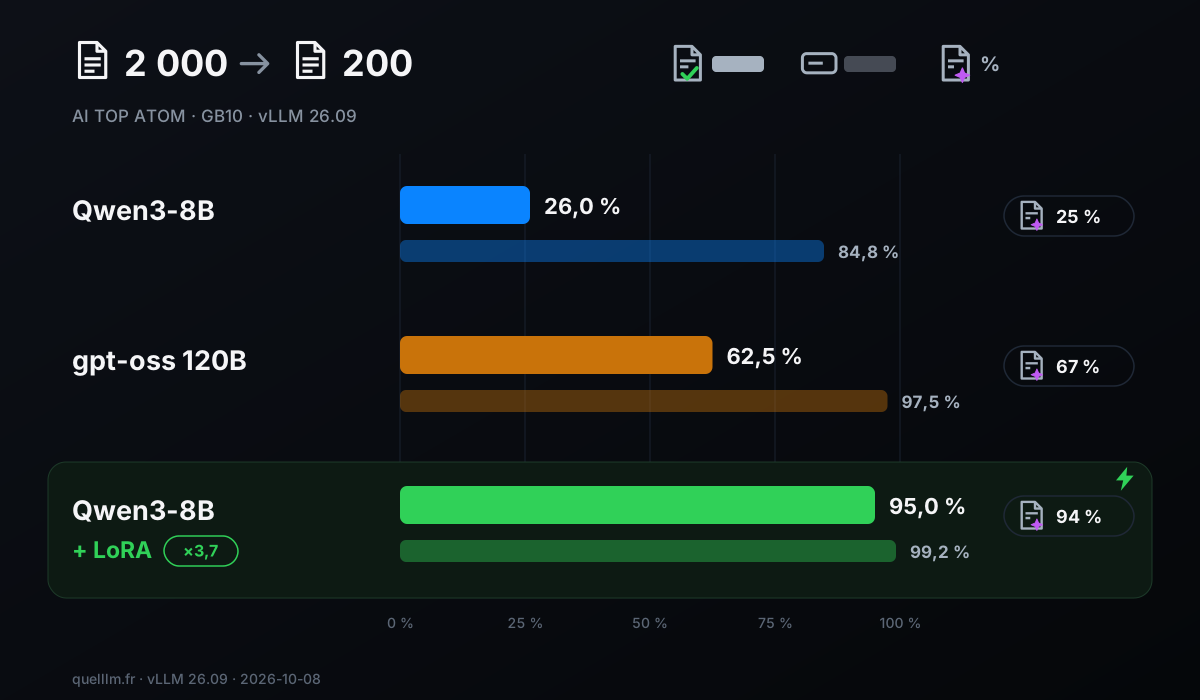
训练后的模型有 95.0% 的文档完全正确,而未经训练的同一模型只有 26.0%:提高了 69 个百分点,无错误文档数量达到 3.7 倍。它还超过了拥有 1170 亿参数的 gpt-oss 120B(62.5%)。它也是速度最快的:处理 200 份文档用时 524 秒,而 gpt-oss 120B 用时 991 秒,未经训练的 Qwen3-8B 用时 686 秒。它的回答也更短:输出 98847 个 token,而 gpt-oss 120B 输出 160702 个。
在 100 份版式从未见过的文档上,训练后的模型仍有 94% 的完美文档和 98.5% 的准确字段,而在已知版式上分别为 96% 和 99.9%。完美文档的差距为 2 个百分点(96% 对 94%):适配器的能力并不局限于训练中见过的版式。
按字段查看的明细显示了训练修正的内容。全部 31 个字段在至少 97.5% 的文档中都准确无误,其中 18 个字段在 100% 的文档中准确无误。未经训练时,有 10 个字段的准确率介于 49.5% 和 61.5% 之间:包括金额类字段(折扣、总额、增值税、预付款、应付净额)和明细行字段(数量、单价、增值税税率、金额)。训练后,这 10 个字段的准确率达到 98% 至 100%。
这三个模型在 100% 的情况下都返回有效的 JSON,并在 100% 的文档中找到了正确的行数。因此,差异体现在字段的值上,而不是回答的格式上。
#成本:时间、内存、电力
| 测量 | 数值 |
|---|---|
| 训练时长 | 5,090 秒,即 85 分钟(每步 10.2 秒) |
| PyTorch 记录的 GPU 内存峰值 | 33.3 GB |
| GPU 功率,平均值与峰值 | 53.0 W 和 62.7 W |
| GPU 温度,平均值和最大值 | 65 °C 和 77 °C |
| GPU 报告的降频 | 5206 条读数中没有任何一条 |
| 训练的 GPU 能耗(记录 87 分钟,含加载时间) | 76.7 Wh |
| 按 EDF Tarif Bleu Base 电价计算的成本(每 kWh 20.01 欧分,含税) | 1.5 欧分 |
| 用训练后的模型读取 200 份测试文档的 GPU 能耗 | 约 6 Wh |
这些数字仅针对 GPU,是芯片自身报告的数值。据 NVIDIA 称,nvidia-smi 显示的功耗仅为 GPU 的功耗。处理器、内存、SSD 和电源均未计入。电价采用 EDF 的 Base 选项(6 kVA),依据 2026 年 8 月 1 日起适用的价目表;订阅费未计入。
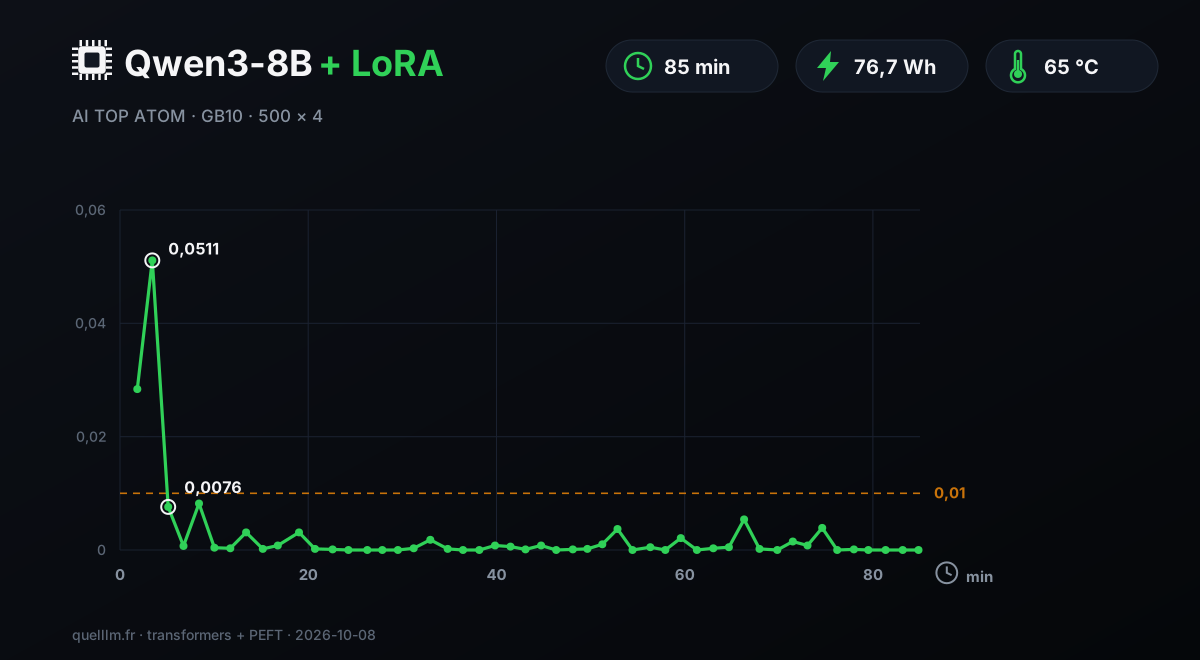
曲线上的每个点都来自单独一批 4 份文档,因此各次记录的数值会有波动。从第 30 步起,也就是训练 5 分钟后,损失降至 0.01 以下,此后的记录均未超过 0.0082。在这个案例中,仅一个 epoch 就足以达到 95% 的文档完全正确率。
#使用 Unsloth 进行 QLoRA:在同一台机器上训练一个 70B 模型和 gpt-oss 120B
QLoRA 将模型权重压缩到 4 位,从而大幅减少其内存占用,然后在其上训练 LoRA 适配器。这是无需更换机器就能让大模型专业化的途径。我们使用了 Unsloth,这是一款开源工具,据其开发方称,它能让微调更轻量、更快速。
NVIDIA 发布了在 DGX Spark 上使用 Unsloth 的官方指南,运行于 NVIDIA 的 PyTorch 容器(版本 25.11)中,同时还提供官方 PyTorch 微调环境,适用于 10 亿到 700 亿参数的模型。Unsloth 宣称 gpt-oss 120B 的 4 位 QLoRA 约需 68 GB 内存;我们测得的峰值为 64.4 GB,处于同一量级。
我们测量了两个模型的速度和内存:Llama 3.3 70B 和 gpt-oss 120B,两者均采用 Unsloth 发布的 4 位格式。每次试验包含 40 步,前 10 步用于启动,不计入平均值。
序列长度为 1024 个 token,批大小为 1,LoRA 秩为 16。这些步骤基于我们测试规程中的参考文本运行,用于测量吞吐量和内存;它们不会产出可用的模型。
| 模型 | Chargement | 模型内存 | GPU 内存峰值 | 每步秒数 | 每秒 token 数 | 训练的参数量 |
|---|---|---|---|---|---|---|
| Llama 3.3 70B(QLoRA 4 位) | 247 s | 37.6 GB | 41.3 GB | 9,39 | 109 | 2.07 亿(7 个投影) |
| gpt-oss 120B(4 位 QLoRA) | 397 s | 58.5 GB | 64.4 GB | 6,35 | 161 | 1190 万(4 个注意力投影) |
| Qwen3-8B(LoRA bf16) | — | — | 63.4 GB | 5,42 | 756 | 4360 万(7 个投影层) |
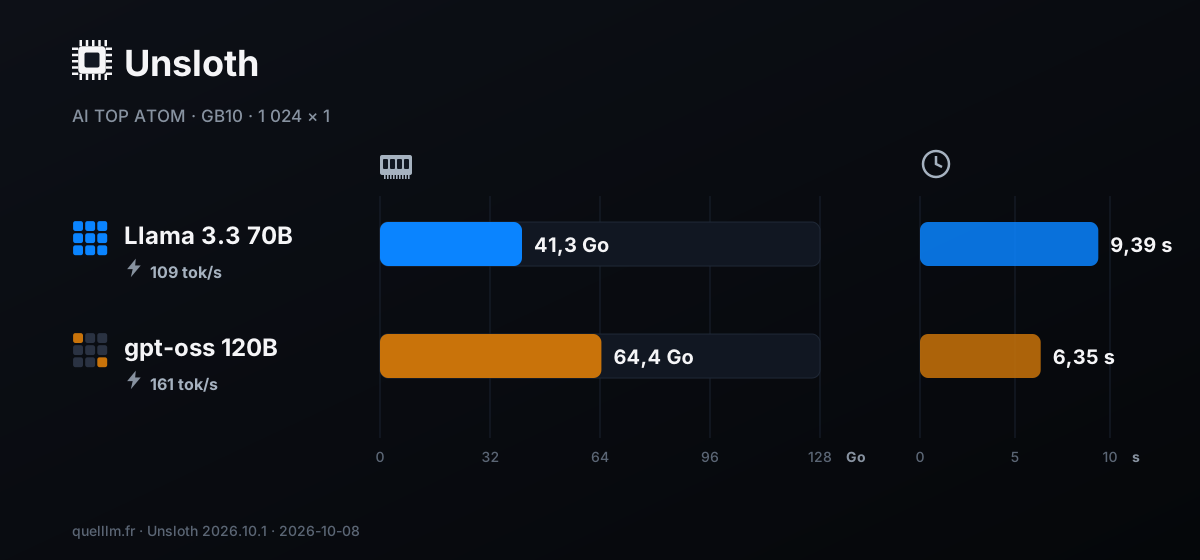
70B 训练时的峰值为 41.3 GB,约为系统可见 121.7 GB 的三分之一;gpt-oss 120B 则需要 64.4 GB。两种情况下都还有余量运行其他服务。值得注意的是,gpt-oss 120B 虽然体积更大,但每步速度比 70B 更快(6.35 s 对 9.39 s)。
这是一个 MoE(混合专家)模型:每个 token 只会使用其 117B 个参数中的 5.1(单位与总数相同)。我们只训练 attention 的 4 个矩阵(q、k、v、o),共 11.9M 个参数。70B 模型的 7 个投影层使用 LoRA,训练参数共 207M 个。
为便于规划,以下是根据我们的测量结果推算的数据。1000 步、每步 1024 个 token,即约一百万个 token,使用 70B 模型需要 2 小时 36 分钟,使用 gpt-oss 120B 需要 1 小时 46 分钟。请在您自己的数据集上核实这些时长。70B 模型的 QLoRA 占用 GPU 10.8 分钟(含模型加载时间),GPU 侧耗电 8.9 Wh。
Unsloth 2026.10.1 安装在与上文相同的 Python 环境中,位于同一个 PyTorch 容器内。如需分步安装说明,请参阅 NVIDIA 官方指南和 Unsloth 文档,链接见本页末尾。
#使用 vLLM 提供训练后模型的服务
vLLM 是一款开源服务器,专为同时响应多个用户而设计;我们使用的是 NVIDIA 提供的容器版本。它先加载原始模型,再添加适配器。随后 API 会提供两个名称:Qwen3-8B(不带适配器)和 factures(带适配器)。我们在同一台服务器上对两者进行了评估,因此比较是公平的。
每次并发发送 16 份文档时,处理这 200 张发票需要 524 秒。按此速度,1,000 张发票约需 44 分钟:这是根据我们的实测结果推算出来的。端口绑定在本地地址 127.0.0.1。如需向你的网络开放该服务,请添加 API 密钥;关于生产环境中 vLLM 的指南详细介绍了这一步骤。
#在你自己的环境中分五步复现本案例
- 01准备样本收集成对数据:文档文本及其预期的 JSON 回答。只编写一条提示词,训练和评估都使用这同一条。我们使用了 2000 个样本;我们没有测量最低样本数门槛。
- 02留出测试集预留一部分文档,始终不让模型看到。再加入一些训练中未出现过的版式,以判断模型是否具备泛化能力。
- 03训练一个 epoch按长度对样本排序,组成批次,仅针对回答部分计算损失,并监控损失曲线。
- 04训练前后分别评分使用同一提示词,逐字段为原始模型和训练后的模型评分。同时也为一个未经训练的大模型评分:这是最有价值的对比。
- 05使用 vLLM 提供服务通过 enable-lora 选项加载适配器,并将您的软件接入 API。
#微调、RAG 还是更好的提示词:该如何选择?
先从提示词入手:它免费且立竿见影。如果模型需要从您的文档中查找事实,RAG 更合适:这是一种先在您的文件中检索、再作答的助手。
当任务重复出现、输出格式必须保持稳定,并且您手头有示例时,微调就是合适的工具。读取发票满足这三个条件。两种方法可以在同一台机器上结合使用;本系列的另一篇指南展示了一个完整的 RAG 助手。
#我们测量的局限
- 虚构文档
- 我们的发票由脚本生成,共有 12 种版式。真实文档(扫描件或照片)需要先进行文字识别(OCR),结果也可能有所不同。
- 仅一次训练
- 我们只训练了一个适配器,并在温度为 0 的条件下对每个模型各评分一次。我们没有测量不同训练之间的差异,也没有与更长时间的训练进行比较。
- gpt-oss 120B
- 它的评分是在低推理强度下得出的。换用其他设置,得分可能会变化。
- QLoRA
- QLoRA 测量针对的是速度和内存,共 40 步。我们没有评估训练后的 70B 或 120B 模型的质量。
- 能耗
- 它仅涉及 GPU 本身。
- 不在范围内
- 我们没有测量训练模型全部参数的情况,也没有测量多台机器互联使用的情况。
更新与更正:如果 Unsloth、vLLM 或 DGX OS 的新版本改变了这些结果,本页将进行修订;每项更正都会注明日期。
#谁适合选择 ATOM
- 希望让小模型专门处理自身文档的中小企业或事务所
- 只需 85 分钟和 GPU 侧 1.5 欧分的电费,就能在我们的虚构发票数据集上将完全正确的发票比例从 26% 提升到 95%,而且没有向第三方发送任何一份文档。
- 构建原型的开发者或数据团队
- LoRA 方式的 Qwen3-8B、QLoRA 方式的 70B 模型或 gpt-oss 120B:三者都能在同一台机器上运行,GPU 内存峰值为 33 到 64 GB。
- 希望在同一个地方完成训练、评估和模型服务的团队
- 同一台机器完成了适配器训练和三个模型的评分,并通过 vLLM 提供回答。
- 没有机房的办公室
- 一个一升容量的机箱(150 × 150 × 50.5 mm,1.2 kg),由 240 W USB-C 适配器供电。
我们把平台和厂商分开来看。NVIDIA GB10 芯片、128 GB 统一内存(273 GB/s)、CUDA 和 DGX OS 7.5.0 在很大程度上决定了训练速度。在推理方面,我们的测量结果与 DGX Spark 已公布数据的差距最多为 4.3%;本指南中的训练均在 AI TOP ATOM 上完成。
GIGABYTE 提供机箱及其双风扇散热系统。在训练期间 87 分钟的记录中,GPU 侧平均功率为 53 W,温度平均保持在 65 °C,最高 77 °C,未报告任何降频。
ATAGB10-9001(128 GB,4 TB PCIe 4.0 SSD)于 2026 年 10 月 8 日记录的价格:AORUS 官方商店售价 6346.27 €(含税),当时已售罄;Amazon.fr 当时有货。我们测量的是 ATAGB10-9000 型号,其 SSD 为 PCIe 5.0。GB10 的价格每周都在变动:购买前请先核实。
#FAQ
在 GB10 上微调一个 80 亿参数的模型需要多长时间?+
能在 128 GB 上微调 70B 模型或 gpt-oss 120B 吗?+
经过训练的小模型真的能超过大模型吗?+
一次微调的电费是多少?+
训练完成后如何使用适配器?+
微调必须使用 128 GB 版本的 ATOM 吗?+
有反馈、发现了错误,或想补充说明?请告诉我们,让这份指南对每个人都更有帮助。