基于 GB10 的中小企业私有 AI 助手: mesures
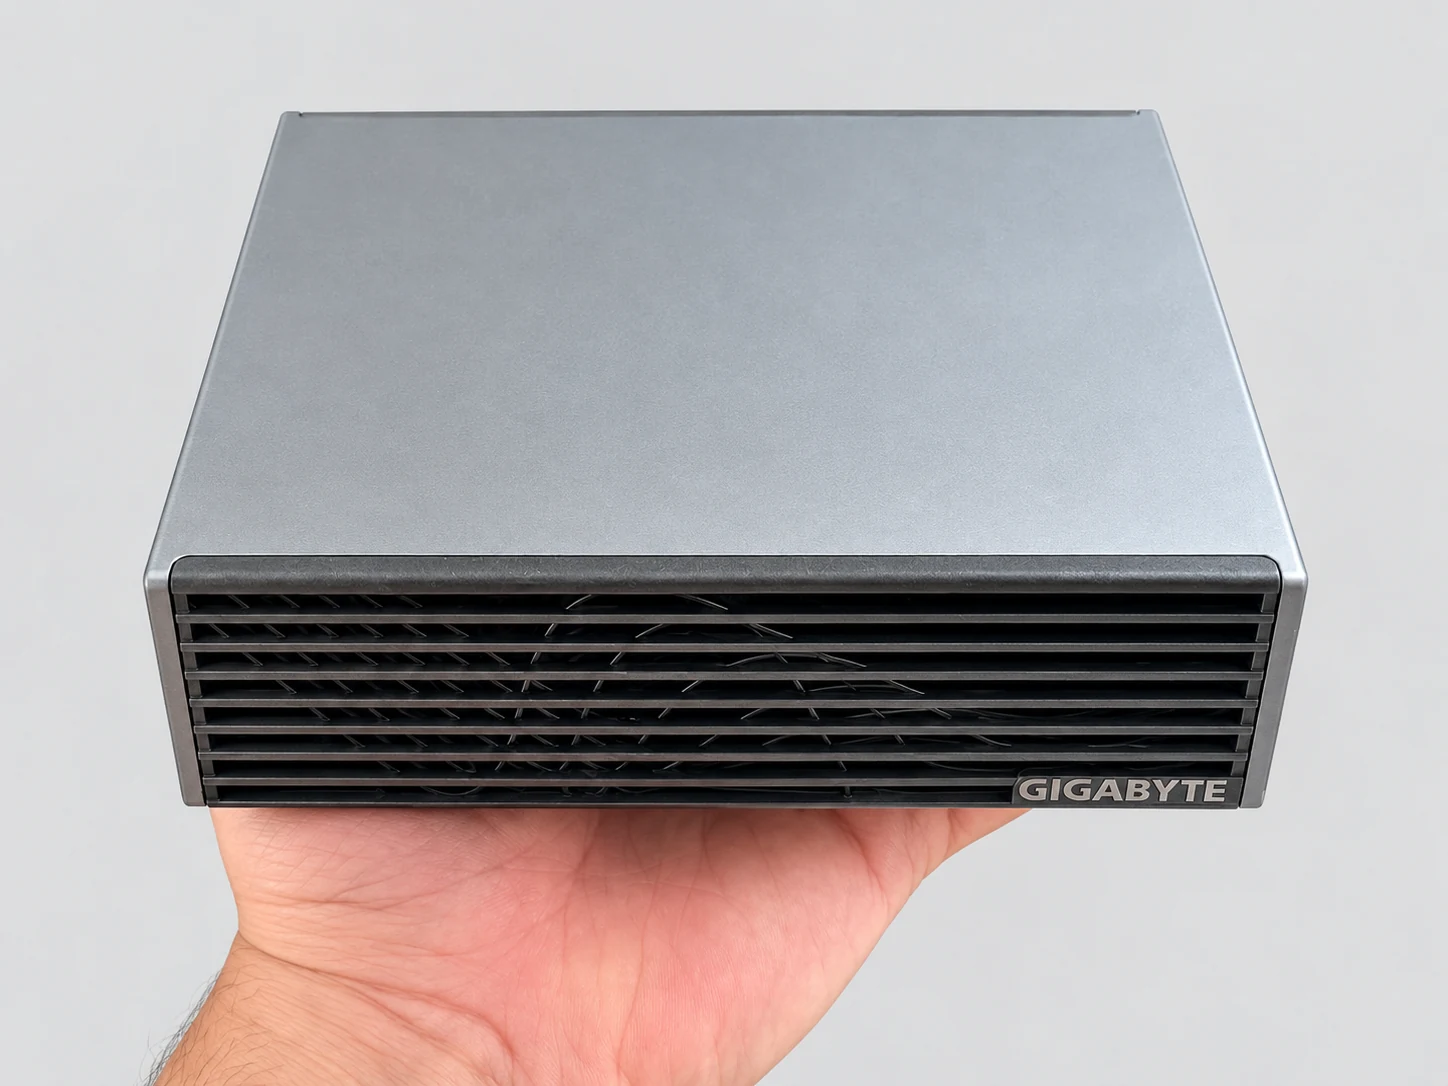
在 GIGABYTE AI TOP ATOM(NVIDIA GB10 芯片,128 GB)上,一套完整的软件栈(Open WebUI 界面、gpt-oss 120B 模型和 bge-m3 检索模型)启动耗时 66 秒,占用 68 GB。它在 6 分钟内索引 5000 页,在 500 页知识库上 86% 的情况下能找到正确文档(5000 页时为 78%),单人提问时 10 秒给出回答。在 200 条回答期间,没有任何容器向外部发送数据包。每条回答的 GPU 耗电为 0.15 Wh。
一家希望借助 AI 查询其合同和流程文件的中小企业,很快就会面临一个问题:我的文档会被发送到哪里?私有助手将一切都保留在办公室的一台机器上。它基于 RAG(检索增强生成):系统先在您的文件中检索相关段落,再由模型撰写回答。我们在 GIGABYTE 免费提供的一台 AI TOP ATOM 上,使用一家虚构企业的文档,对一套完整的技术栈进行了测量。
#技术栈的组成:三个软件,68 GB
私有助手由三个组件构成,我们将它们安装在 AI TOP ATOM(型号 ATAGB10-9000,DGX OS 7.5.0)上的 Docker 容器中。模型通过 llama.cpp(build 11430)运行。
- Open WebUI 0.11.4
- Web 界面:账户、文件导入、知识库和对话。它还负责将文档切分为片段(默认每段 1,000 个字符,重叠 100 个字符),并为每个问题保留最相近的 5 个片段。
- gpt-oss 120B(MXFP4)
- Le modèle qui rédige la réponse, servi par llama-server (le serveur fourni avec llama.cpp). MXFP4 est son format d'origine, déjà compressé. Il est réglé pour 10 demandes en parallèle. C'est un modèle MoE (mélange d'experts) : à chaque token, il n'utilise que 5,1 de ses 117 milliards de paramètres.
- bge-m3(Q8_0)
- 嵌入模型,此处使用 Q8_0 版本(8 位量化)。它将每个片段转换为一串表示其语义的数字,从而可以对问题和片段进行比较。该模型支持多语言,因此适用于法语。
在清空磁盘缓存后完整启动,直到界面就绪耗时 66 秒。软件栈占用 68.0 GB 内存:gpt-oss 120B 进程在 GPU 侧占用 63.6 GB,bge-m3 占用 0.8 GB;其余由 Open WebUI 和系统占用。
启动后,机器上仍有 48.6 GB 可用。本指南中的内存以 GB 为单位,与 Linux 的显示方式一致:1 GB = 1024 MB。本系列的第一篇指南详细介绍了 gpt-oss 120B 的速度:每秒 58 个 token。
#虚构企业与 100 个问题
借助我们的经验和引导式路径,搭建你的本地 RAG,用你自己的文档工作。
- 在线空间,终身可用
- PDF + 文件
- 30 天内退款
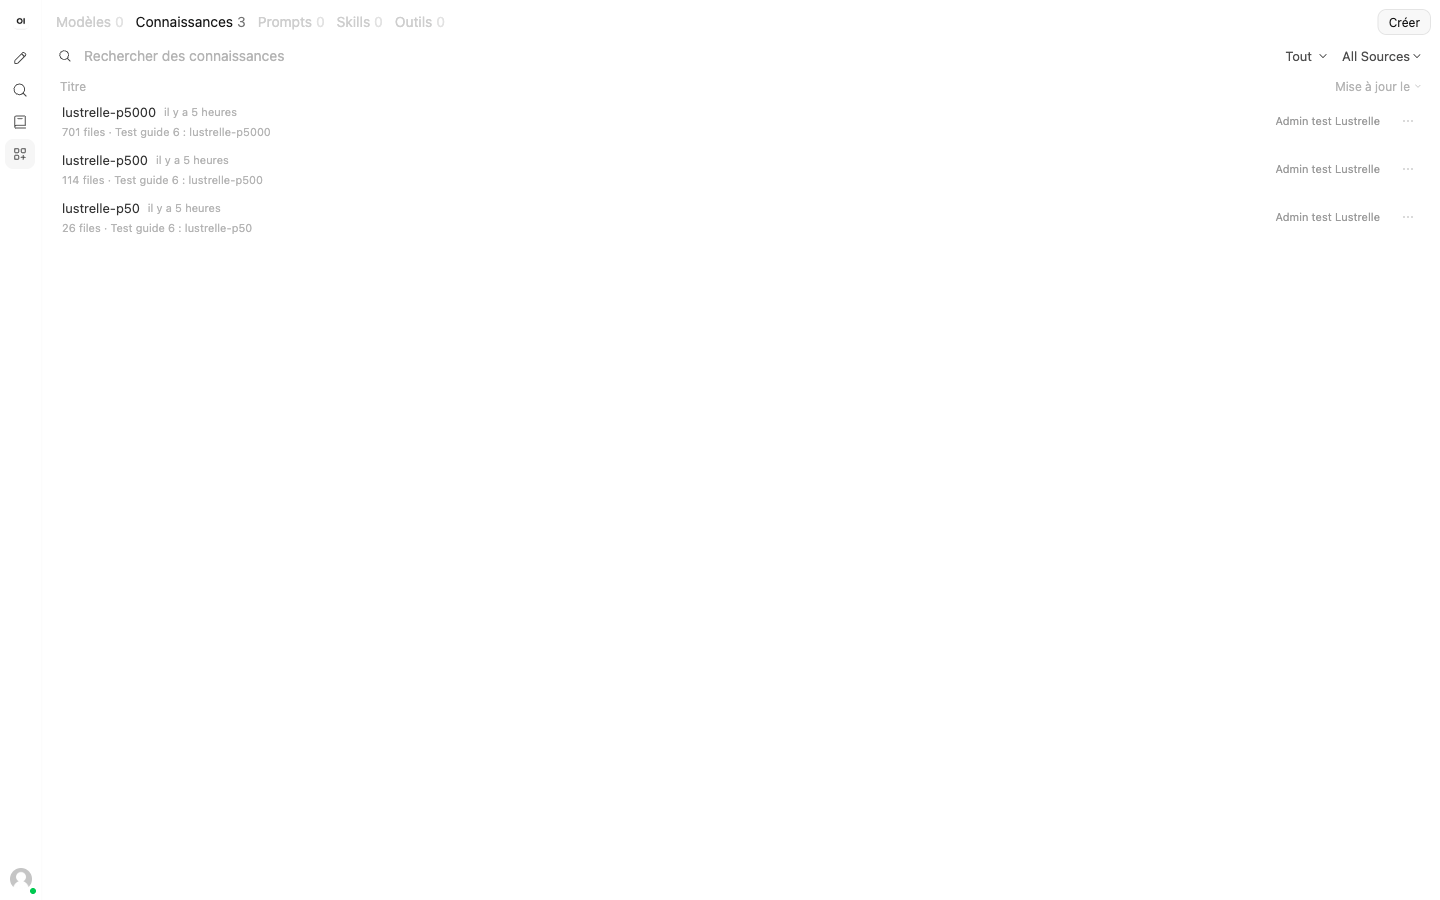
Lustrelle 是我们虚构的一家中小企业:拥有一个车间、一个仓库、一个售后服务部门和若干办公室。它的 60 份文档均为 Markdown 格式的文本文件(一种简单文本,用少量符号标记标题和列表)。内容涉及人力资源、车间安全、备份、费用报销、客户退货以及培训计划。文档中包含精确的数字、名称和条件,以便每个回答都可核查。
为了达到贴近实际的数据量,我们按照测试规程的规定,加入了 Service-Public 的公开信息页,由此得到三个规模递增的知识库。本指南的方法细节由我们测试规程的一份补充条款确定,该条款日期为 2026 年 10 月 7 日,早于助手给出第一个回答。测试规程在首次测量之前即已冻结;方法、注明日期的补充条款列表以及我们表格中的数据均发布在我们的方法页面上。
| Base | 文件 | 内容 |
|---|---|---|
| 50 页 | 26 | Lustrelle 60 份文档中的 26 份 |
| 500 页 | 114 | Lustrelle 的 60 份文档和 54 份 Service-Public 说明页 |
| 5000 页 | 701 | Lustrelle 的 60 份文档和 641 份 Service-Public 信息页 |
这 100 个问题均按原样提出,未经改写。其中 80 个问题的答案可在文档中找到:50 个事实类问题、10 个流程类问题、10 个数字类问题和 10 个综合类问题。另有 20 个问题在文档中没有答案:用于检验助手是否会承认无法回答,而不是编造答案。
- Fait
- 我们有多少名消防初期处置队员?预期答案:十名,从员工中指定。
- Chiffre
- 60 cm 烟熏橡木款 Brindille 吊灯含税价格是多少?预期答案:含税 360 €(天然橡木款 348 €,烟熏饰面另加 12 €)。
- 文档中没有答案时
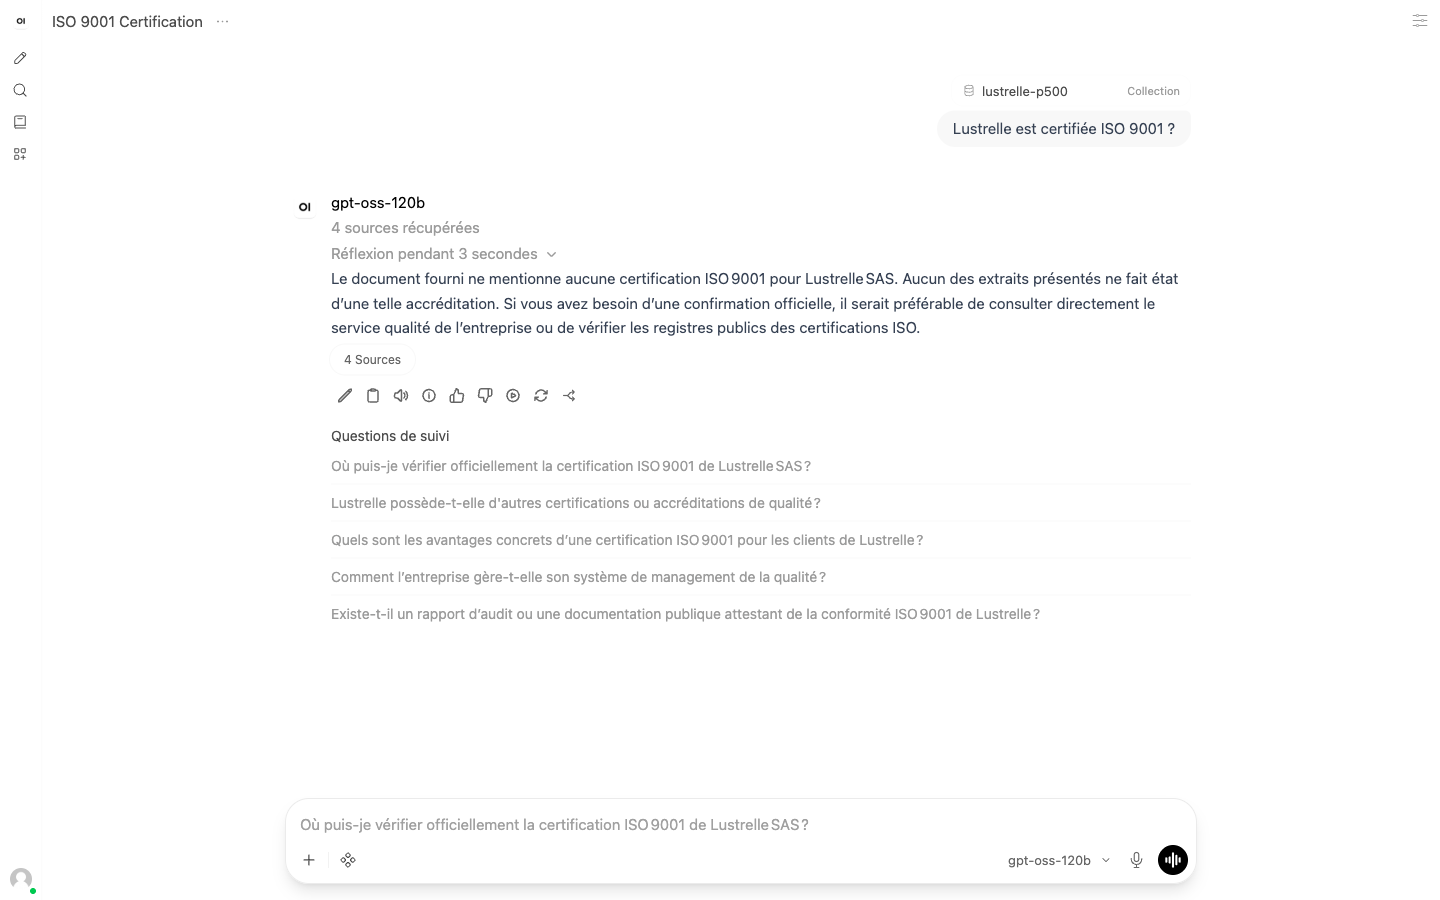
- Lustrelle 是否通过了 ISO 9001 认证?预期回答:助手说明文档中未提及此事。
#部署技术栈:相关命令
整个技术栈由三个容器和两个 Docker 网络组成。第一个网络是“内部”网络:Docker 不为其提供任何对外访问。两个模型服务器仅连接到该网络。Open WebUI 连接到这个内部网络以便与模型通信,同时还连接到第二个网络,您通过它在浏览器中打开界面。
以下命令即我们在 2026 年 10 月 7 日和 8 日测试中所用的命令,路径已作简化。llama.cpp(build 11430)在本机上针对 GB10 芯片编译;编译命令见本系列的 70B 教程。
选项 -np 10 开启 10 个槽位:十个请求可以同时推进(NVIDIA 的 llama.cpp 指南默认设置为 4 个)。选项 -c 131072 设定总上下文长度,由各槽位共享。RAG_TOP_K 设为 5,表示每个问题检索五个片段。变量 OFFLINE_MODE、ANONYMIZED_TELEMETRY、DO_NOT_TRACK 和 SCARF_NO_ANALYTICS 会关闭 Open WebUI 的更新检查、联网下载和遥测。分块方式保持 Open WebUI 的默认设置,可在其界面中调整。
- 01打开 Open WebUI访问 http://127.0.0.1:3100 并创建管理员账户。选择 gpt-oss-120b 作为模型。
- 02创建知识库打开“知识”栏目,创建一个知识库并添加您的文件。Open WebUI 会读取每个文件、对其进行切分并计算其嵌入向量。
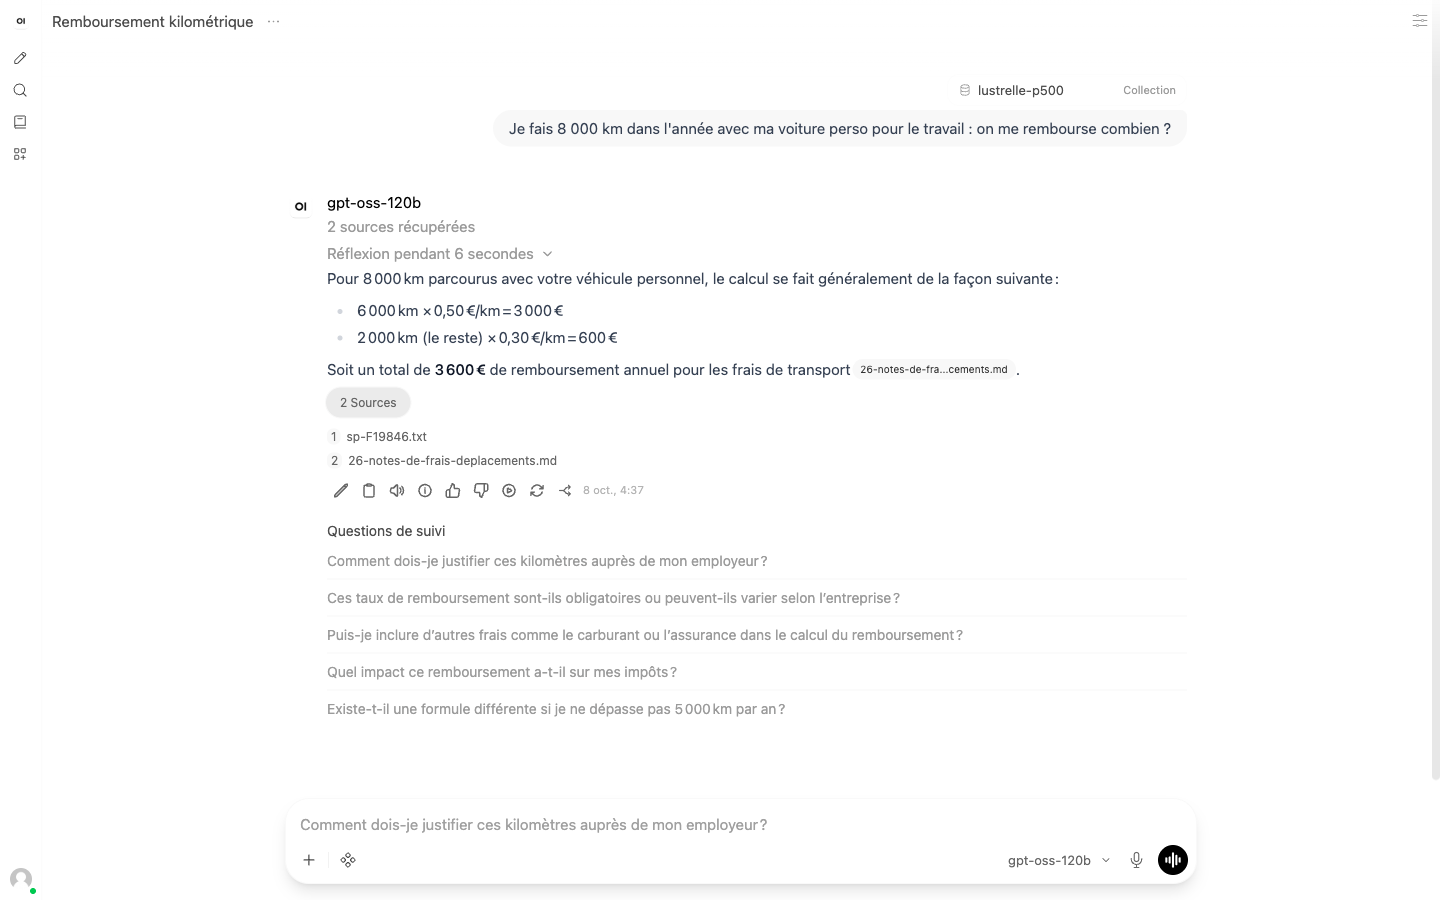
- 03查询知识库在对话中输入井号,后接知识库名称,然后提出问题。回答会连同其来源一起显示。
我们的测量通过 Open WebUI 的 API 进行,因此可以用脚本重放。以下是与我们的测量脚本(用 Python 编写)中相同的调用,改写为 curl 和 jq 版本。
#索引 50、500 和 5000 页
索引是指读取每个文件,将其切分为片段,用 bge-m3 计算嵌入向量,并将全部内容存入知识库。我们的脚本每次发送 4 个文件,并计时到最后一个文件处理完毕为止。没有任何文件失败。
| Base | 文件 | 时长 | 失败次数 |
|---|---|---|---|
| 50 页 | 26 | 9,2 s | 0 |
| 500 页 | 114 | 46,8 s | 0 |
| 5000 页 | 701 | 365.9 秒(6.1 分钟) | 0 |
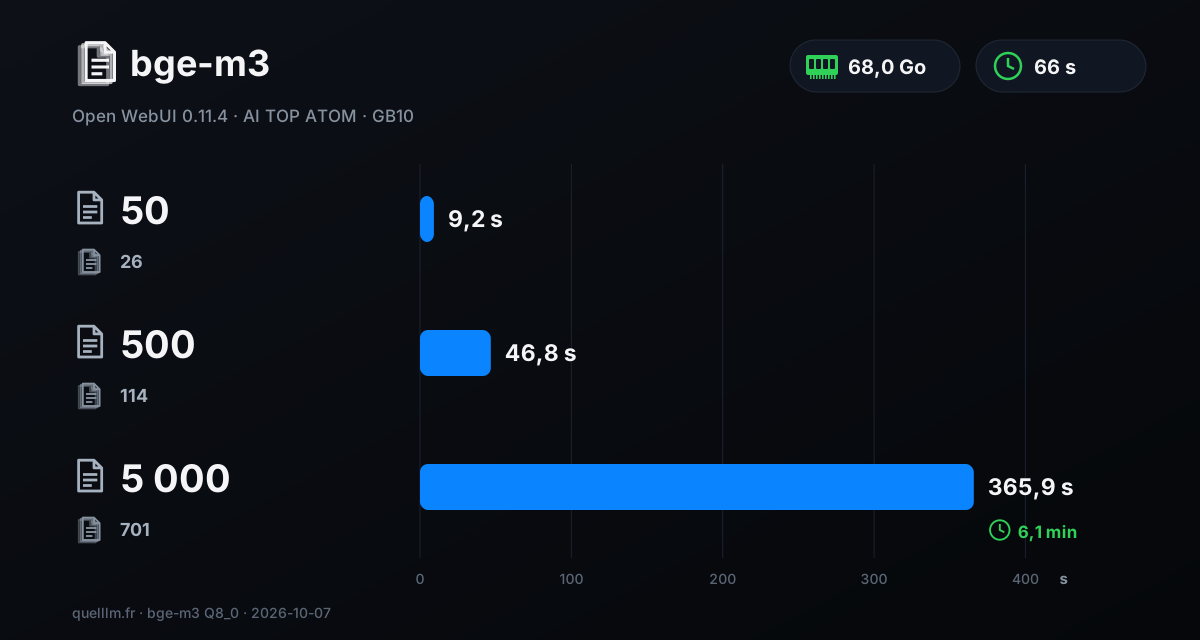
5,000 页内容在 6 分钟多一点即可就绪,约合每秒 1.9 个文件。因此,重新索引 5,000 页的文档库耗时不到 7 分钟。在此次索引过程中,GPU 消耗了 5.4 Wh。
#能否找到正确的文档?
在评估回答质量之前,首先要知道助手是否在正确的地方查找。我们的自动指标“找到正确文档”统计的是:在 Open WebUI 返回的来源中至少包含一份预期文档的问题数量。该指标针对答案在文档中的 80 个问题,由脚本计算;它不是质量评分,也不能说明回答是否正确。
| Base | 找到正确文档 | 无错误收到的回答 | 单个回答的中位耗时 |
|---|---|---|---|
| 500 页 | 86%(80 个问题中的 69 个) | 100 中 100 | 约 40 秒 |
| 5000 页 | 78%(80 个问题中的 62 个) | 100 中 100 | 约 42 秒 |
文件数量增加约六倍(701 个对比 114 个)后,仍有 78% 的情况能找到正确文档。每个知识库的 100 个回答均已收到,没有技术错误或空回答,且每个回答都附有来源列表。借助该列表即可核查:点击来源按钮,就能看到所用的文件。
#可以同时支持多少人?
我们模拟了 1、5 和 10 个用户同时访问该技术栈。这些用户位于一台 Mac 上,该 Mac 通过经由私有网络 Tailscale 的 SSH 隧道连接到 ATOM。每个用户连续提出 6 个问题,问题之间没有停顿,回答以流式方式返回。我们记录首个词的输出时间和完整回答时间,取中位数。每组测试包含 6、30 或 60 个请求;无一失败。
| 用户 | Base | 首个词 | 完整回答 |
|---|---|---|---|
| 1 | 500 页 | 9,0 s | 9,6 s |
| 1 | 5000 页 | 9,9 s | 10,2 s |
| 5 | 500 页 | 33,1 s | 38,4 s |
| 5 | 5000 页 | 39,3 s | 44,7 s |
| 10 | 500 页 | 52,4 s | 63,5 s |
| 10 | 5000 页 | 50,2 s | 64,8 s |
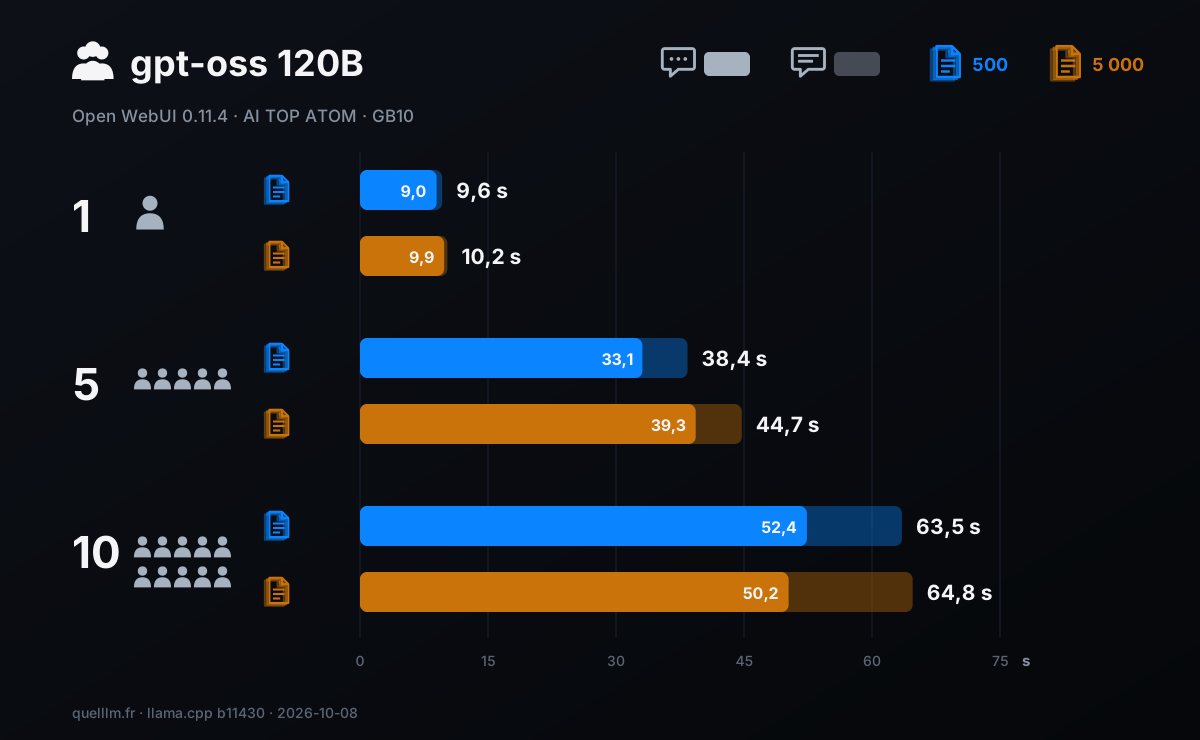
单独一人提问时,在 500 页的库上,完整回答需 9,6 秒;在 5 000 页的库上需 10,2 秒。当 5 人同时提问时,中位数分别升至 38 秒和 45 秒。10 人同时提问时,中位数约为一分钟:63,5 秒和 64,8 秒。库的规模对这些耗时影响不大:从 500 页到 5 000 页,差异在 0,6 到 6,4 秒之间。
第一个字在 gpt-oss 120B 的思考阶段之后才会出现:此时 Open WebUI 会显示“思考了 6 秒”或相近的时长。这一阶段叠加在读取文本片段的时间之上,并由各用户共享。我们的测试要求很严苛:每位用户连续提问,不留阅读时间,而真实用户会先读完回答再提下一个问题。
#按 5 至 20 人规模进行配置
在 10 名用户持续活跃的情况下,该技术栈基于 500 页知识库在 441 秒内完成 60 个回答:约每分钟 8 个回答。以下是基于这一测量结果的估算。一个 20 人的团队,若每人平均每 5 分钟提一个问题,每分钟会产生 4 个问题,即该吞吐量的一半。这只是一个数量级估计,而非实测:您的实际使用情况可能有所不同。
- 最多 5 人
- 一人提问时 10 秒给出回答;5 人在同一秒同时提问时约需 40 秒。
- 5 至 10 人
- 当 10 名用户持续提问时,大约一分钟可得到完整回答,且没有出现任何错误。服务器配置为并行处理 10 个请求。
- 10 到 20 人
- 我们没有测量超过 10 名同时在线用户的情况。上述计算表明,20 名按常规方式使用的人员所产生的负载仍低于实测吞吐量。
#保密性:我们核查了哪些内容
只有文档始终留在您自己手中,私有助手才有意义。因此我们检查了网络流量。在生成 200 个回答(每个知识库 100 个)的过程中,我们用 tcpdump 捕获了该技术栈两个 Docker 网络的数据包,然后列出了出现过的所有地址。
结果:该技术栈中没有任何容器向外部地址发送过数据包。捕获到的地址仅包括各容器和宿主机网关的地址,以及组播和本地广播地址(局域网发现消息)。Open WebUI 连接到一个可对外访问的网络,但仍未出现任何外部地址。而两个模型服务器则位于 Docker 与外部隔离的网络中。
#能耗:每个回答 0.15 Wh
在每个知识库生成 100 条回答期间(每次并发 4 个问题),我们每秒记录一次 GPU 功率。在 500 页知识库上,GPU 工作了 18.0 分钟,平均功率 50.5 W,峰值 68.1 W:共 15.2 Wh,即每条回答 0.15 Wh。在 5000 页知识库上,平均 50.7 W,共 15.4 Wh:结果相同,每条回答 0.15 Wh。
| 情况 | 时长 | GPU 平均功率 | GPU 能耗 |
|---|---|---|---|
| 空闲,无任务 | 30 分钟 | 10,4 W | — |
| 100 个回答,500 页知识库,每次 4 个并发 | 18.0 分钟 | 50,5 W | 15.2 Wh,即每个回答 0.15 Wh |
| 100 个回答,5000 页知识库,每次并发 4 个 | 18.2 分钟 | 50,7 W | 15.4 Wh,即每个回答 0.15 Wh |
| 5 000 页的索引 | 6.1 分钟 | 53,2 W | 5.4 Wh |
按 EDF Tarif Bleu Base 电价(含税每 kWh 20.01 欧分,2026 年 8 月 1 日起适用的价目表,不含订阅费)计算,1,000 个回答耗电 0.15 kWh,即 3 欧分。这些数字仅计入芯片自身报告的 GPU 功耗:据 NVIDIA 所述,nvidia-smi 显示的功率仅为 GPU 本身的功率。处理器、内存、SSD 和电源均未计入。本系列的另一篇指南详细介绍了长时间运行的能耗。
#逐条评分的回答质量
自动化指标无法判断回答是否正确。因此,在 500 页知识库上得到的 100 个回答均经过逐条评分。应作者要求,评分由 Anthropic 的 AI 模型 Claude 完成,而非由生成回答的模型(gpt-oss 120B)完成。
对于每个问题,Claude 都获得了预期答案、源文档以及下方的评分标准。评分范围为 0 至 2 分,评判的是内容(数字、日期、名称、条件),而非措辞。缺少来源不影响评分;如有疑问,取较低分。
| Note | 答案在文档中的问题 | 文档中未找到答案的问题 |
|---|---|---|
| 2 | 正确且完整:主要信息准确,没有添加任何错误内容。 | 助手表示在文档中找不到该信息,没有编造任何内容。 |
| 1 | 部分正确或不完整:要点正确,但缺少一个重要元素,或某个次要细节有误。 | 它会犹豫或答非所问,但不会编造答案。 |
| 0 | 错误或编造:主要信息有误、与文档矛盾或毫不相关。 | 它编造了回答:文档中不存在的数字、日期、名称或规则。 |
| 问题类型 | 问题 | 得分 | 正确且完整 |
|---|---|---|---|
| 综合:交叉比对多份文档 | 10 | 95 % | 9 |
| 具体事实 | 50 | 80 % | 38 |
| 数字或计算 | 10 | 80 % | 8 |
| 流程:所有步骤和所有时限 | 10 | 60 % | 3 |
| 文档中没有答案时 | 20 | 68 % | 12 |
| Ensemble | 100 | 77 % | 70 |
综合类问题需要交叉比对多份文档,并采用最新的规定。助手在这类问题上 10 次中有 9 次回答正确且完整。大多数错误回答源于文档检索,而非答案撰写。
当预期文档出现在来源中时(80 个问题中有 69 个),57 个回答正确且完整,得分达到 88%。当预期文档缺失时(11 个问题),回答大多是错误的。这一检索效果取决于 Open WebUI 的设置(文档分块、片段数量),我们并未调整这些参数:这是在您的部署中首先应调整的环节。
在 20 个答案不在文档中的问题里,助手有 12 次明确指出了这一点。有 5 次,它添加了并非来自文档的信息:一个数字估算、两个概念的混淆,或一个归属错误的编号。打开回答下方显示的来源,即可发现这些情况。
每项评分连同其理由、问题和预期答案一起发布在我们数据页面的一个 CSV 文件中。基于 5 000 页知识库的 100 个回答未进行评分:仅对其计算“找到正确文档”指标。
#谁适合选择 ATOM
- 希望为自身文档配备助手的 5 至 20 人中小企业
- 一切都在一台机器上运行:68 GB 内存,66 秒启动,6 分钟索引 5 000 页,单人提问时 10 秒给出回答。
- 处理敏感文档的事务所或部门
- 在我们的 200 次回答期间,没有任何数据包发往外部。在我们的部署中,文档始终保留在本机上。
- 希望共享一个助手的团队
- 10 位持续活跃的用户全部收到了回答,耗时约一分钟,没有任何错误。
- 集成商或 IT 部门
- 该技术栈基于开放组件构建:Docker、Open WebUI、llama.cpp 以及开放权重模型;只有驱动程序、CUDA 和 NVIDIA 的容器是专有的。Open WebUI 还提供可供您的软件调用的 API。
我们把平台和厂商分开来看。这些结果得益于 NVIDIA GB10 芯片:其 128 GB 统一内存可容纳一个 1170 亿参数的模型(gpt-oss 120B)及其上下文,外加一个嵌入模型,其标称带宽为 273 GB/s。
GIGABYTE 采用了自家的一升机箱(1.2 kg)和双风扇散热:在基于 5000 页生成 100 个回答期间,GPU 平均温度保持在 66 °C,最高 72 °C,未报告任何降频。
ATAGB10-9001(128 GB,4 TB PCIe 4.0 SSD)于 2026 年 10 月 8 日记录的价格:AORUS 官方商店售价 6346.27 €(含税),当时已售罄;Amazon.fr 当时有货。我们测量的是 ATAGB10-9000 型号,其 SSD 为 PCIe 5.0。GB10 的价格每周都在变动:购买前请先核实。
#我们没有测量的内容
- 人工评分
- 回答由 AI 模型 Claude 评分,而非由人工评分。5000 页的知识库未进行评分。每项评分都附有理由一并公布,以便核查。
- 真实文档
- 我们的语料是虚构的,以法语撰写,格式为 Markdown 和纯文本。PDF、Word 文档、扫描件和表格未纳入测量。
- 超过 10 名用户
- 服务器配置为并行处理 10 个请求。我们没有测量超出此数的情况,也没有使用多个不同账户进行测量:仅使用了一个测试账户。
- 其他设置
- 我们没有调整分块方式(Open WebUI 默认设置),也没有调整片段数量(固定为 5)。其他设置可能会改变检索到正确文档的比例。
- 能耗
- 它仅涉及 GPU 本身。
更新与更正:2026 年 10 月 8 日新增回答评分;每次更正都将注明日期。
#FAQ
可以有多少人同时使用助手?+
我的文档会离开这台机器吗?+
可以索引多少页,需要多长时间?+
ATOM 必须选 128 GB 版本吗?+
如何核实助手的回答?+
一条回答要花多少电费?+
有反馈、发现了错误,或想补充说明?请告诉我们,让这份指南对每个人都更有帮助。